Aktualisiert am 16. November 2026 · Cameron Voss und West Mao
Qwen4-Max: Kosten, Benchmarks und wie man es bewertet (November 2026)
Angegebene Listenpreise, überprüft am 16. November 2026. Thinking-Tokens werden als Ausgabe in Rechnung gestellt.
- 11. NovemberQwen 4 mit einer Max-Vorschau angekündigt.
- 11. bis 15. NovemberQoDuck läuft anonym in Qoder.
- 16. NovemberQwen4-Max wird mit Pay-as-you-go-API ausgeliefert.
- WeiterKleinere Qwen 4-Modelle mit offenen Gewichten versprochen.
Die Sequenz von der Vorschau bis zum Start. Das letzte Kästchen ist ein Versprechen, kein Datum.
Was sich seit der Vorschau geändert hat
Fünf Tage vor der Veröffentlichung war das einzige verfügbare Qwen-4-Modell eine Vorschau mit einem angekündigten Enddatum. Dieses Vorschaufenster endete vorzeitig: Am 16. November 2026 veröffentlichte Alibaba Qwen4-Max mit Listenpreisen, einer nutzungsbasiert abgerechneten API und einer Benchmark-Tabelle. Wenn Ihr Testplan auf den 25. November ausgerichtet war, ist diese Frist nicht mehr entscheidend. Jetzt geht es darum, ob das veröffentlichte Modell Ihre Aufgaben erfüllt.
Auch die Form des Angebots hat sich geändert. Die Vorschau betraf nur den Token-Plan, und der vor diesem Start veröffentlichte Leitfaden besagte dies. Qwen4-Max kann jetzt mit Pay-as-you-go-Abrechnung oder über den Token-Plan aufgerufen werden und ist in Qwen Studio, QwenWork und Qoder verfügbar. Das Modell ist nicht Open Source; Alibaba sagt, dass kleinere Qwen 4-Modelle mit offenen Gewichten folgen werden, die auf die gleiche Weise trainiert werden.
Eine praktische Konsequenz: Tragen Sie keine Modell-ID aus einer Vorschau-Integration mit. Lesen Sie die Live-Modellliste des von Ihnen genutzten Dienstes noch einmal durch, da es sich bei der stabilen Version um ein anderes Angebot handelt, auch wenn der Name ähnlich aussieht.
Was es kostet, in Dollar und in Punkten
Die Listenpreise betragen 1,50 US-Dollar pro Million Eingabetoken, 4,50 US-Dollar pro Million Ausgabetoken und 0,075 US-Dollar pro Million Token im impliziten Cache. Der Cache-Preis entspricht 5 % des Preises für neue Eingaben. Wiederverwendeter Kontext ist damit deutlich günstiger als neuer Kontext.
Ein Beispiel: Eine Aufgabe mit einer Million Eingabe- und 200.000 Ausgabetoken kostet 2,40 US-Dollar, wenn alle Eingaben neu sind. Werden alle Eingabetoken aus dem Cache bedient, kostet dieselbe Aufgabe 0,975 US-Dollar. Der Unterschied zeigt, warum die Reihenfolge der Prompts und die Wiederverwendung von Sitzungen bei der Kostenplanung wichtig sind.
Ein Job mit 1 Mio. Eingaben und 200.000 Ausgaben
Ausgabepreis bei 4,50 $ pro Million. Zur Veranschaulichung, vor Tools und Wiederholungsversuchen.
Cache-Treffer hängen von der Eingabeaufforderungsstruktur und dem Anbieterverhalten ab. Ein Lesevorgang, der den Cache verfehlt, wird als neuer Input abgerechnet.
Unser Multi-Model-Gateway rechnet in Punkten ab. Für qwen4-max-preview ist ein Multiplikator von 15× veröffentlicht: Jedes Eingabe- oder Ausgabetoken zählt als 15 Punkte. Die Aufgabe mit insgesamt 1,2 Millionen Token kostet somit 18 Millionen Punkte. Alle Modelle des Plans teilen sich das Guthaben. Prüfen Sie die aktuellen Kontingente und die Modellverfügbarkeit vor dem Kauf.
Punkte pro 1 Mio. Token
Punkte = (Eingabe-Tokens + Ausgabe-Tokens) × Multiplikator.
Die oben genannten Dollarpreise und der Punktesatz unten sind unterschiedliche Abrechnungssysteme. Vergleichen Sie sie anhand der Kosten pro akzeptiertem Ergebnis, nicht anhand der Schlagzeilenrate.
Wo das Modell stark ist und welche Ihrer Aufgaben dazu passen
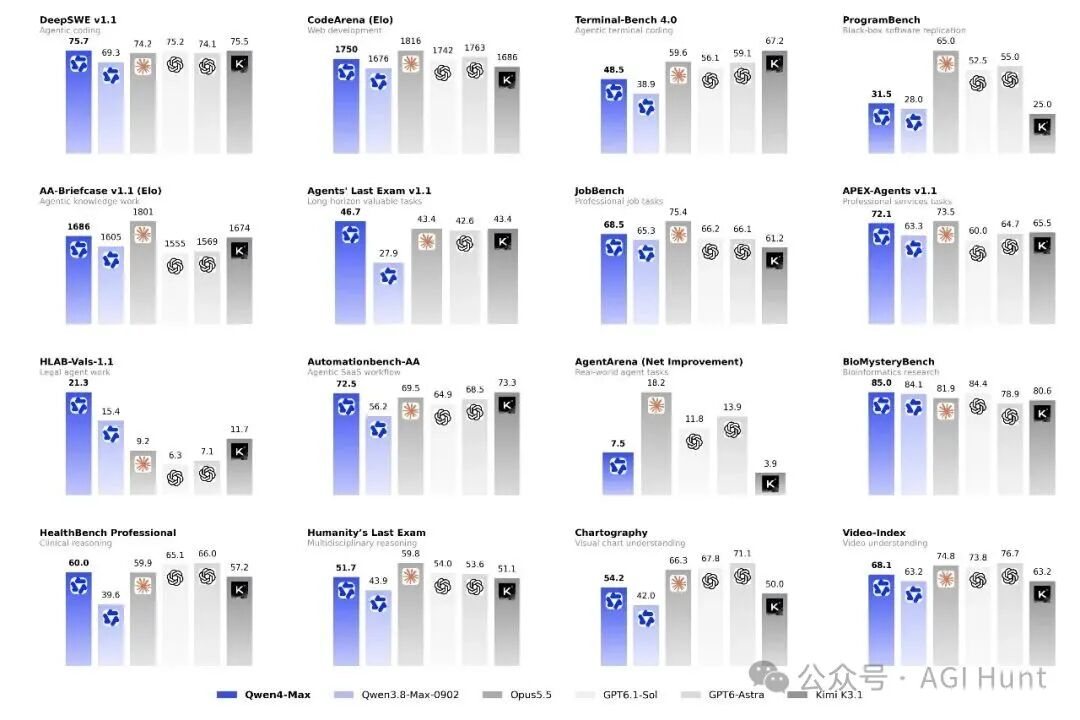
Die Starttabelle gibt Qwen4-Max den ersten Platz bei DeepSWE v1.1 mit 75,7, Agents' Last Exam v1.1 mit 46,7, BioMysteryBench mit 85,0 und HLAB-Vals-1.1 mit 21,3. Der letzte ist ein Benchmark für juristische Agenten, bei dem Opus 5.5 einen Wert von 9,2 erreicht.
Die vier Ergebnisse zeigen ein Leistungsprofil, keine allgemeingültige Rangliste. Softwareentwicklung, länger laufende Agentenaufgaben, biologische Forschung und dokumentenintensive juristische Arbeit liefern jeweils Ergebnisse, die sich anhand von Quellen prüfen lassen. In diesen Bereichen liegen auch Alibabas Beispiele: Due Diligence mit unterschiedlichen Dokumenten, Finanzarbeitsmappen mit nachvollziehbaren Zellen und Intensivstationsdaten mit Bezug zu ärztlichen Anordnungen.
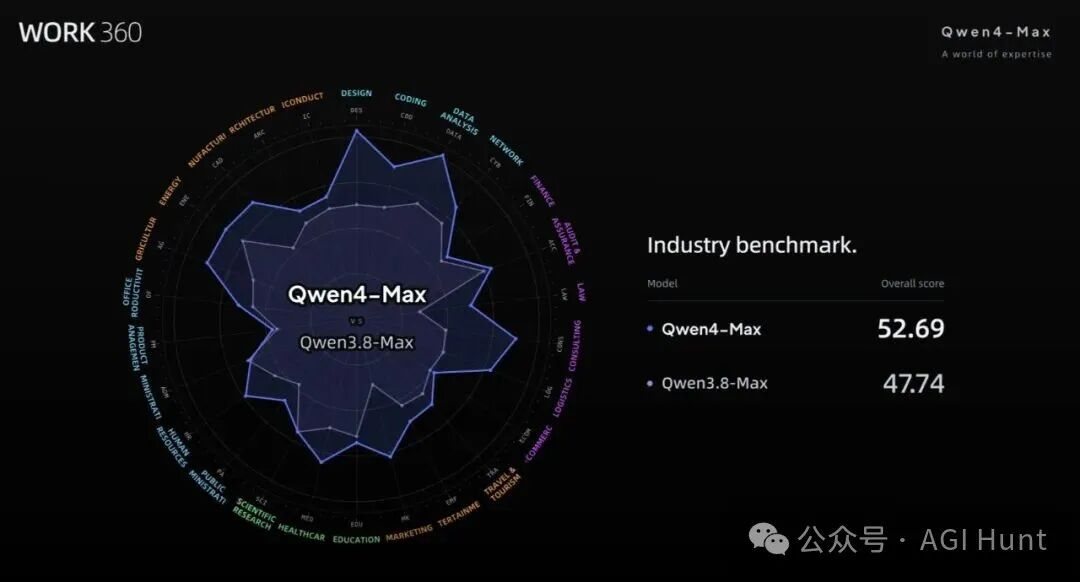
Der Anbieter hat für diese Einführung auch Work360 mit 26 First-Level-Domains, 182 Subdomains und 721 Spezialgebieten entwickelt. Qwen4-Max erreicht einen Wert von 52,69 gegenüber 47,74 für die vorherige Generation, etwa 10 %. Ein Benchmark, den der Anbieter entwickelt hat und überarbeiten kann, ist für sich genommen ein schwacher Beweis, aber die Domänenaufschlüsselung ist nützlich für die Auswahl, welche Aufgabe zuerst getestet werden soll.
Wo das Modell zurückliegt und wie Sie diese Bereiche testen
Zwei Verluste fallen auf. Terminal-Bench 4.0 erzielt einen Wert von 48,5 gegenüber Kimi K3.1 bei 67,2 und ProgramBench, das eine funktionierende Reproduktion bestehender Software verlangt, erzielt einen Wert von 31,5 gegenüber Opus 5.5 bei 65,0. Diagrammverständnis und AgentArena platzieren es im gleichen Vergleich am Ende.
Das sind die drei Achsen, die vor einer Migration einen speziellen Test wert sind. Wenn sich Ihr Agent in einer Shell befindet, übergeben Sie ihm eine Aufgabe, die eine Befehlsfolge, einen Fehler und eine Wiederherstellung erfordert. Wenn Sie einen Legacy-Dienst verwalten, fordern Sie eine verhaltenskompatible Neufassung einer bereits vorhandenen Testsuite an. Wenn Ihr Workflow mit einem Diagramm, einem Dashboard-Screenshot oder einem Diagramm beginnt, prüfen Sie, ob das Modell Werte korrekt liest, anstatt Formen zu beschreiben.
Der Anspruch auf Token-Effizienz und wie man ihn überprüft
Der Start behauptet, dass XHigh und High Thinking etwa 24 % bzw. 35 % weniger Tokens als die vorherige Generation auf Work360 verwenden und etwa 48 % und 49 % weniger bei Terminal-Bench 4.0. Zusammen mit den niedrigeren Tarifen sinken dadurch die durchschnittlichen Kosten einer Work360-Aufgabe von 4,43 $ auf 1,67 $, was einer Reduzierung um 62 % entspricht.
Übertragen Sie diese Zahl nicht direkt auf Ihre Rechnung. Die Einsparung entsteht durch weniger Reasoning-Token und hängt davon ab, wie viel Rechenaufwand Ihre Prompts auslösen. Protokollieren Sie für dieselbe Aufgabe bei beiden Modellen Eingabe-, Cache-, Ausgabe- und Reasoning-Token. Zählen Sie die Token pro akzeptiertem Ergebnis statt pro Versuch: Ein Modell, das pro Token 30 % günstiger ist, aber zwei zusätzliche Versuche braucht, muss insgesamt nicht günstiger sein.
Machen Sie dasselbe bei Low und XHigh. Wenn „Niedrig“ die meisten Qualitätslücken bei Ihren Aufgaben schließt, ist die Standardeinstellung die teure.
Langzeitarbeit: Was Live Delivery beim Testen ändert
Mit der Einführung wird Live Delivery hinzugefügt: Anstatt bis zum Ende still zu arbeiten, gibt der Agent frühzeitig eine verwendbare erste Version zurück und iteriert dann, sodass Sie die Richtung vor dem teuren Teil korrigieren können. Alibaba hat das begleitende Qwen-Live-Delivery-Plugin als Open-Source-Lösung bereitgestellt.
Das verändert das Aussehen eines guten Tests. Anstatt nur das endgültige Artefakt zu bewerten, notieren Sie, wann das erste Ergebnis eintraf, ob es verwendbar war und wie viele Eingriffe Sie vor der letzten Version vorgenommen haben. Ein Modell, das nach vier Korrekturen einen guten Endzustand erreicht, ist ein schlechterer Agent als eines, das in einem Durchgang einen brauchbaren Entwurf erreicht, selbst wenn die Endergebnisse identisch aussehen.
Die Launch-Demos basieren auf diesem Muster: ein Spiel, das erstellt und dann selbst getestet wird, eine Produktionslinie, die modelliert und dann anhand einer Simulation korrigiert wird, ein Molekül, das in vier Schleifen entworfen, synthetisiert und überarbeitet wird.
Sechs Demos als Aufgabenvorlagen
Die Demoliste eignet sich eher als Testvorlagensatz denn als Beweis. Jede Zeile unten ist etwas, das Sie auf eine Aufgabe verkleinern können, die Ihr Team bewerten kann.
Scrollen Sie auf kleineren Bildschirmen seitwärts durch die Tabelle.
| Demo | Was der Anbieter berichtet hat | Vorlage, die Sie ausführen können |
|---|---|---|
| Blender- und Spiel-Builds | Szenen von einem weißen Modell bis zu einer gerenderten Aufnahme; Unreal Engine- und Unity 6-Spiele, eines davon für Android gepackt | Geben Sie dem Agenten ein Tool, das er ausführen kann, und fordern Sie dann einen spielbaren Build und einen bestandenen Selbsttest an |
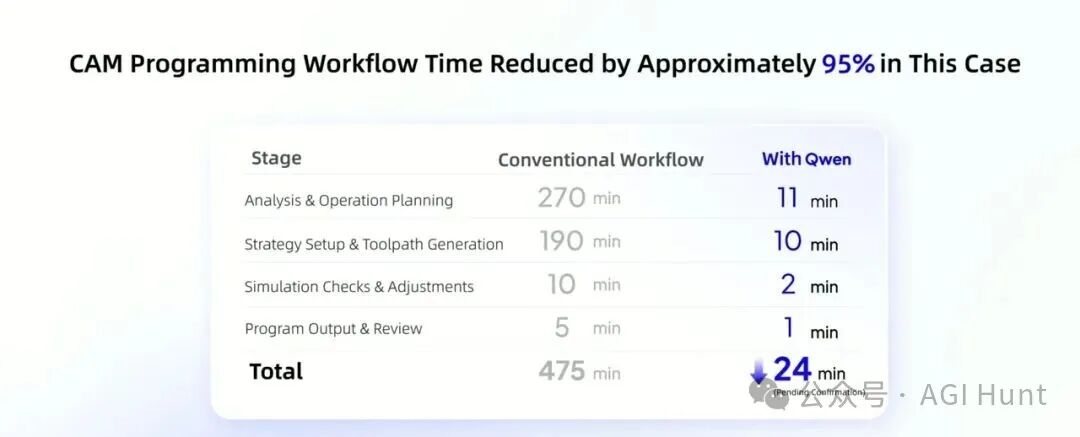
| Fertigung | 3D-Linie aus einem 2D-Layout, virtuelle SPS-Inbetriebnahme, Werkzeugwege; Von 475 auf 24 Minuten pro Werkstück | Eine Geometrie- oder CAD-Konvertierung mit einer Simulationsprüfung und einer messbaren Zykluszeit |
| Materialien | Neues Kühlmittelmolekül entworfen und synthetisiert nach vier Design- und Testschleifen | Eine Suchschleife mit einem echten Validierungsschritt, keine Textantwort |
| Arzneimitteldesign | 454 Toolaufrufe, 3.239 Bewertungen, 24 Kandidaten, 3,6-fache vorhergesagte Affinität | Ein langer, durch Tools gesteuerter Lauf, bei dem der Fortschritt nur real ist, wenn sich die Bewertungsfunktion bewegt |
| Finanzen | 90 MCP-Tools, Excel und Deck mit Rückverfolgbarkeit vom Diagramm zur Zelle | Eine Datenaufgabe aus mehreren Quellen, bei der jede Zahl auf eine Zelle zurückgeführt werden muss |
| Recht und Medizin | Due-Diligence-Prüfung von 198 Dokumenten mit Zitaten; sechs Tage Intensivaufzeichnungen mit zeilenweiser Korrespondenz | Ein eigener Dokumentenstapel, in dem jede Schlussfolgerung eine Quelle benötigt |
Vom Anbieter gemeldete Ergebnisse, umgeschrieben als Aufgaben, die Sie mit Ihren eigenen Daten bewerten können.
Ein einwöchiger Evaluierungsplan
Scrollen Sie auf kleineren Bildschirmen seitwärts durch die Tabelle.
| Tag | Was auszuführen ist | Was aufzuzeichnen ist |
|---|---|---|
| 1 | Ein Repository, ein Harness, zwei Modelle, ein Aufwandsgrad | Modell-ID, Anbieter, Region, Datum, Aufwandsgrad, Kontexteinstellung |
| 2 | Ein fehlgeschlagener Test, eine Funktion für mehrere Dateien, eine Shell-Sequenz mit einem erzwungenen Fehler | Erfolgsquote gegenüber zuerst geschriebenen Tests, Wiederholungsversuchen, Toolfehlern, Wiederherstellungsschritten |
| 3 | Eine verhaltenskompatible Neufassung einer vorhandenen Suite | Regressionen, versteckte Fehler, Überprüfungszeit |
| 4 | Ein Diagramm oder Screenshot-Aufgabe, plus eine lange Eingabe mit Fakten am Anfang, in der Mitte und am Ende | Werte richtig gelesen, Widersprüche aufgefangen, an jeder Position abrufen |
| 5 | Die gleichen Aufgaben bei Low und XHigh | Token pro akzeptiertem Ergebnis, Reasoning-Token, Dollar oder Punkte pro akzeptiertem Ergebnis |
| 6 | Eine langfristige Aufgabe mit Live Delivery | Zeit bis zur ersten verwendbaren Version, Eingriffe, endgültige Qualität |
| 7 | Sieger zweimal wiederholen, Spuren archivieren, Standard benennen | Eingabeaufforderungen, Einstellungen, Ausgaben, Ergebnisse, Daten, Ausgaben |
Ein Ausgangspunkt. Schneiden Sie alles aus, was Ihrer Arbeit nicht ähnelt, und bewahren Sie die Aufzeichnungen auf.
Archivieren Sie das Paket, wenn Sie fertig sind. Die nächste Qwen 4-Version, einschließlich der kleineren Modelle mit offenem Gewicht, kann dann anhand der gleichen Aufgaben an einem Tag statt in einer Woche gemessen werden.
Wenn Sie offene Gewichte oder eine günstigere Basislinie benötigen
Qwen4-Max ist geschlossen. Alibaba verspricht kleinere Qwen 4-Modelle mit offenem Gewicht aus der gleichen Generation, nennt kein Datum. Wenn offene Gewichte eher eine Anforderung als eine Präferenz sind, wird diese Version nicht erfüllt, und eine Entscheidung sollte auf die kleineren Modelle warten.
Für Aufgaben mit hohem Volumen, die kein Spitzenmodell benötigen, bleibt DeepSeek Flash mit einem Multiplikator von 1× eine günstige Vergleichsbasis in unserem Plan. Bei gleichem Tarif stehen dafür wesentlich mehr Token zur Verfügung. Nutzen Sie für den Vergleich denselben Test-Harness. Ein möglicher Ansatz ist, das günstigere Modell standardmäßig einzusetzen und Qwen4-Max für lange Aufgaben mit höherem Wert hinzuzuziehen.
Vergleichen Sie die Modelle mit demselben Test-Harness. Ein Modell kann in einem Agenten schwächer und in einem anderen stärker wirken. Ändern Sie beides gleichzeitig, lässt sich der Einfluss des Modells nicht vom Einfluss der Umgebung trennen.
Häufig gefragt
Ist Qwen4-Max freigegeben?
Ja. Alibaba brachte Qwen4-Max am 16. November 2026 als erstes Modell der Qwen 4-Familie auf den Markt. Die API ist auf QwenCloud mit Pay-as-you-go- und Token-Plan-Abrechnung verfügbar, und das Modell ist auch in Qwen Studio, QwenWork und Qoder verfügbar.
Wie viel kostet Qwen4-Max?
Die angekündigten Listenpreise betragen 1,50 $ pro Million Input-Tokens, 4,50 $ pro Million Output-Tokens und 0,075 $ pro Million Implizite Cache-Token. Überprüfen Sie vor der Budgetierung die Live-Preise des Anbieters und denken Sie daran, dass Thinking Tokens als Output abgerechnet werden.
Ist Qwen4-Max Open Source?
Nein. Alibaba sagt, dass Qwen4-Max selbst kein Open Source ist und dass kleinere Qwen 4-Modelle, die mit derselben Generation trainiert wurden, später mit offenen Gewichten veröffentlicht werden.
Ist Qwen4-Max das beste Modell bei jedem Benchmark?
Nein. Im eigenen Vergleich des Anbieters führt es DeepSWE v1.1, Agents' Last Exam v1.1, BioMysteryBench und HLAB-Vals-1.1 an, liegt aber hinter Kimi K3.1 bei Terminal-Bench 4.0 (48,5 gegenüber 67,2) und Opus 5.5 bei ProgramBench (31,5 gegenüber 65,0) und liegt bei Chart Understanding und AgentArena ganz hinten.
Bedeutet ein Kontextfenster von einer Million Token, dass Informationen über die gesamte Länge zuverlässig abgerufen werden?
Nein. Das Kontextfenster gibt die Kapazität an, nicht die Zuverlässigkeit des Abrufs, die Latenz oder die Kosten. Testen Sie den Abruf mit Fakten am Anfang, in der Mitte und am Ende einer langen Eingabe und ergänzen Sie ein neueres Dokument, das einem älteren widerspricht.
Kann ich Qwen4-Max über den Multi-Model Coding Plan nutzen?
Unser Gateway veröffentlicht qwen4-max-preview an 15-fachen Punkten auf dem Singapur-Gateway. Durch die stabile Einführung hat sich das Angebot des Anbieters geändert. Schauen Sie sich also die Liste der Live-Modelle an, bevor Sie einen Client konfigurieren oder einen Plan kaufen.
Bedeuten die Token-Einsparungen eine um 50 % günstigere Rechnung?
Nicht automatisch. Die Reduzierungen um 24 % bis 49 % sind die Messungen des Anbieters anhand spezifischer Benchmarks auf bestimmten Reasoning-Stufen. Ihre Ersparnis hängt davon ab, wie viel Ihrer Nutzung Reasoning-Token sind, wie viele Eingaben wiederholt werden und wie viele Versuche eine Aufgabe benötigt.
Das Vorschaufenster ist vorbei. Was bleibt, ist ein Modell, das Sie aufrufen können, ein Preis, den Sie berechnen können, und zwei Benchmark-Zeilen, die Ihnen sagen, wo Sie zuerst suchen müssen. Führen Sie die Woche aus, behalten Sie die Spuren und lassen Sie Ihr eigenes Repository entscheiden.