2026 年 11 月 16 日更新 · Cameron Voss と West Mao
Qwen4-Max: コスト、ベンチマーク、評価方法 (2026 年 11 月)
2026年11月16日時点の発表価格。推論トークンは出力として課金される。
- 11 月 11 日Qwen 4とMaxのプレビュー版を発表。
- 11 月 11 日から 15 日QoDuckはQoderで匿名のまま提供された。
- 11 月 16 日Qwen4-Maxを公開。従量課金APIを利用可能に。
- 次小型のQwen 4モデルをオープンウェイトで公開予定。
プレビューから正式公開までの流れ。小型モデルの公開時期は未定。
プレビュー以降の変更点
5日前に利用できたQwen 4は、終了日が告知されたプレビュー版だけだった。その期間は予定より早く終わり、アリババは2026年11月16日、Qwen4-Maxを正式公開した。料金、従量課金API、ベンチマークも発表されている。11月25日の終了期限を前提にテストを計画していた場合、今後は正式版が自分の業務に合うかどうかを判断する段階になる。
提供形態も変わった。プレビュー版はToken Plan専用だったが、正式版は従量課金またはToken PlanでAPIを利用でき、Qwen Studio、QwenWork、Qoderにも対応する。モデルはオープンソースではない。アリババは、同世代の小型Qwen 4モデルを後日オープンウェイトで公開するとしている。
プレビュー環境で使っていたモデルIDをそのまま引き継がず、利用するサービスの最新のモデル一覧を確認しよう。名前が似ていても、正式版とプレビュー版は別の提供対象だ。
ドルとポイントでの価格
発表時の料金は100万トークンあたり、入力1.50ドル、出力4.50ドル、暗黙キャッシュ0.075ドル。キャッシュ料金は新規入力の5%に相当するため、再利用できる入力は大幅に安くなる。
例えば、入力100万トークンと出力20万トークンのタスクは、入力がすべて新規なら2.40ドル。入力がすべてキャッシュから提供される場合は0.975ドルになる。キャッシュが利用できるかはプロンプトの構造や提供元の仕様に依存する。
入力100万・出力20万トークンのタスク
出力価格は 100 万あたり $4.50 です。ツール利用や再試行を除いた試算。
キャッシュが利用できるかはプロンプトの構造と提供元の仕様による。キャッシュに該当しない入力は新規入力として課金される。
当社のMulti-Modelゲートウェイはドルではなくポイントで課金する。公開されているqwen4-max-previewの倍率は15倍で、入力・出力の各トークンにつき15ポイントを消費する。したがって、合計120万トークンのタスクは1,800万ポイントとなる。各モデルはプランの残高を共有する。購入前に最新の利用枠とモデルの提供状況を確認してほしい。
100 万トークンあたりのポイント
ポイント = (入力トークン + 出力トークン) × 乗数。
上記のドル料金とポイント倍率は異なる課金方式だ。表示単価だけでなく、採用できる成果1件あたりのコストで比較しよう。
モデルの得意分野と、自分の業務で試すべきタスク
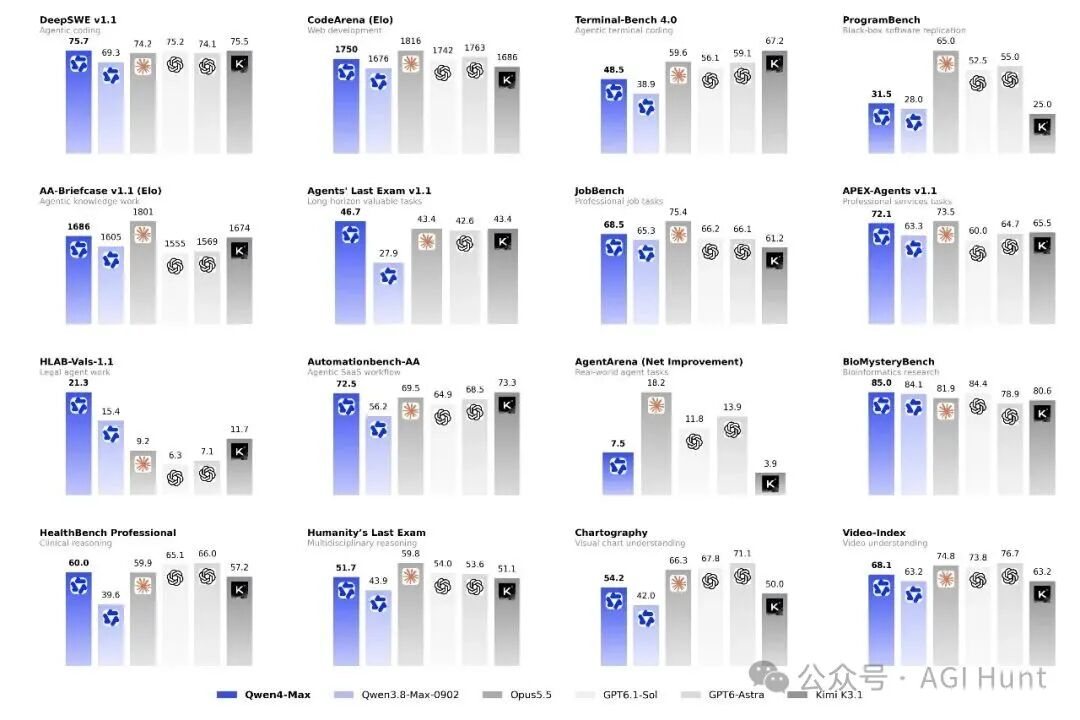
発表時の比較表で、Qwen4-MaxはDeepSWE v1.1で75.7、Agents’ Last Exam v1.1で46.7、BioMysteryBenchで85.0、HLAB-Vals-1.1で21.3を記録し、いずれも比較対象の中で首位だった。HLAB-Vals-1.1は法務エージェントのベンチマークで、Opus 5.5は9.2だった。
これらの数値は、総合順位よりも得意分野を把握する材料として読みたい。ソフトウェア開発、長時間のエージェント作業、生物学研究、大量の文書を扱う法務業務はいずれも、成果物を資料と照合できる。アリババのデモも、複数文書のデューデリジェンス、根拠をたどれる財務ワークブック、医師の指示と照合したICU記録に集中している。
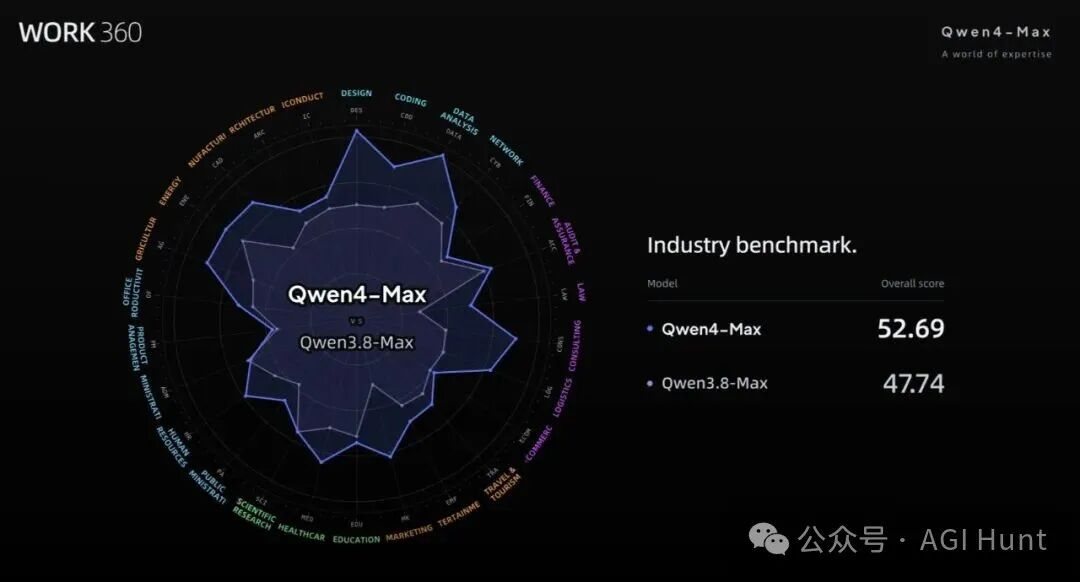
提供元が作成したWork360は、26の大分類、182の小分類、721の専門領域を対象とする。Qwen4-Maxは52.69点で、前世代の47.74点から約10%向上した。提供元が設計・変更できる指標だけでは判断しにくいが、領域別の結果は最初に試すタスクを選ぶ際の参考になる。
弱点と、その検証方法
弱点として目立つのは2つだ。Terminal-Bench 4.0では48.5で、Kimi K3.1の67.2を下回った。既存ソフトウェアの動く再現を求めるProgramBenchでは31.5で、Opus 5.5は65.0だった。チャート理解とAgentArenaでも比較対象の下位に位置する。
移行前には、この3分野を個別に試したい。シェルを使うエージェントなら、一連のコマンドの途中で失敗し、そこから復旧するタスクを与える。既存サービスの保守なら、用意済みのテストスイートに対して動作互換性のある書き換えを求める。グラフやダッシュボード画像を扱うなら、形の説明だけでなく、値を正しく読み取れるか確認する。
トークン効率に関する発表と、その検証方法
発表によると、推論レベルXHighとHighでは、前世代と比べてWork360でそれぞれ約24%、35%、Terminal-Bench 4.0で約48%、49%トークン使用量が減った。料金引き下げと合わせ、Work360の平均タスクコストは4.43ドルから1.67ドルへ62%下がったという。
この数字がそのまま自分の請求額の割引になるわけではない。削減の規模は、プロンプトがどの程度の推論を必要とするかによって変わる。同じタスクを両モデルで実行し、入力、キャッシュ入力、出力、推論の各トークン数を記録しよう。試行ごとではなく、採用できる成果1件あたりのトークン数を比べる。単価が30%安くても、追加で2回やり直すモデルが総額でも安いとは限らない。
LowとXHighでも同じタスクを試そう。Lowで品質差の大部分が埋まるなら、デフォルトの設定は必要以上に高コストかもしれない。
長時間の作業:Live Deliveryでテストはどう変わるか
Live Deliveryでは、エージェントが長いタスクの完了を待たずに、まず使える初版を返し、その後改善を重ねる。ユーザーはコストの大きい工程に入る前に方向を修正できる。関連するQwen-Live-Delivery-Pluginはオープンソースで公開されている。
最終成果物だけでなく、最初に使える版が届くまでの時間、その版が実用に足るか、最終版までに何回介入したかも記録しよう。最終成果物が同じに見えても、4回の修正を要したモデルと1回で使える草案を出したモデルでは、運用上の負担が異なる。
発表時のデモでも、ゲームを作って自らテストし、生産ラインのモデルをシミュレーションに基づいて修正し、分子の設計・合成・改良を4回繰り返していた。
タスク テンプレートとしての 6 つのデモ
デモは性能の証明というより、テスト課題のひな形として役立つ。各事例を、チームで評価できる小さなタスクに置き換えてみよう。
小さい画面では、表を横にスクロールします。
| デモ | ベンダーが報告した内容 | 実行できるテンプレート |
|---|---|---|
| Blender とゲームのビルド | 白いラフモデルからレンダリングまでのシーン、Unreal EngineとUnity 6のゲーム。うち1本はAndroid向けにビルド。 | 実行可能なツールをエージェントに与え、プレイできるビルドの作成と自己テストを依頼する。 |
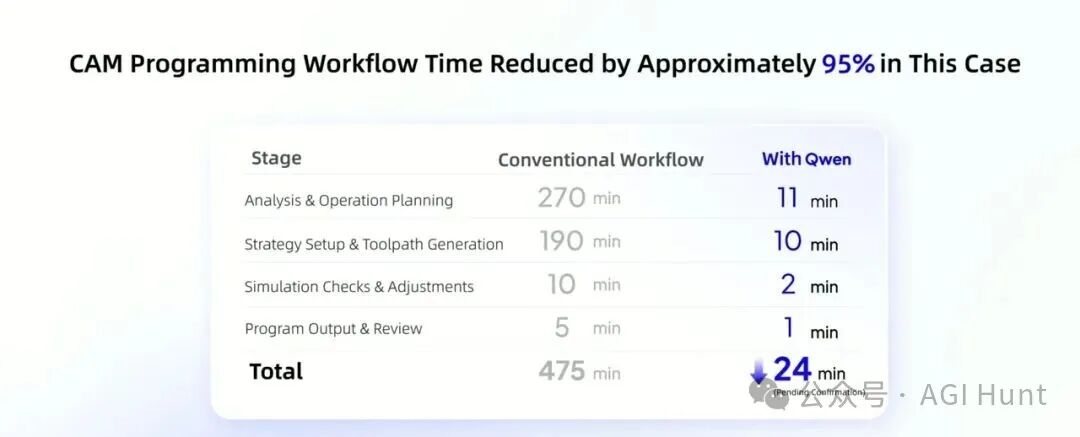
| 製造 | 2D レイアウトからの 3D ライン、PLC 仮想コミッショニング、ツールパス。1部品あたり475分から24分に短縮 | シミュレーション チェックと測定可能なサイクル タイムを備えた形状または CAD 変換 |
| 材料 | 4 つの設計およびテスト ループを経て設計および合成された新しい冷却剤分子 | 文章での回答だけで終わらず、実際の検証工程を含む探索ループ |
| 創薬 | 454 回のツール呼び出し、3,239 回の評価、24 個の候補、3.6 倍の予測親和性 | 評価指標が改善したときにのみ進捗とみなせる、ツールを使った長時間の実行 |
| 金融 | 90のMCPツールを使い、グラフからセルまで追跡できるExcelとスライドを作成 | すべての数値を元のセルまでたどれる、複数ソースを使うデータ処理 |
| 法務・医療 | 出典を付けた198件の文書の調査と、医師の指示に照合した6日分のICU記録 | 各結論に出典を付ける必要がある、自社の文書を使った調査 |
提供元が報告した結果を、自社データで評価できるタスクに置き換えた。
1 週間の評価計画
小さい画面では、表を横にスクロールしてください。
| 日 | 何を実行するか | 何を記録するか |
|---|---|---|
| 1 | 1つのリポジトリとテスト環境で、2モデルを同じ推論レベルで実行 | モデル ID、プロバイダー、リージョン、日付、エフォート レベル、コンテキスト設定 |
| 2 | 失敗するテスト、複数ファイルにまたがる機能、途中で意図的に失敗させるシェル操作 | 事前に作成したテストの合格率、再試行、ツールのエラー、復旧手順 |
| 3 | 既存のスイートに対する動作互換性のある書き換え | リグレッション、隠れた障害、レビュー時間 |
| 4 | チャートやスクリーンショットの読解、および冒頭・中盤・末尾に事実を含む長文入力 | 値の読み取り精度、矛盾の検出、各位置の情報を取り出せたか |
| 5 | Low と XHigh で同じタスク | 採用できた成果1件あたりの総トークン数・推論トークン数・ドルまたはポイントの費用 |
| 6 | Live Deliveryを使った長時間のタスク | 最初の実用的な版までの時間、介入回数、最終的な品質 |
| 7 | 最も良い条件で2回再実行し、記録を保存して標準モデルを決める | プロンプト、設定、出力、スコア、日付、支出 |
これは評価の出発点だ。自分の業務に合わない項目は省き、実施した結果を記録しておこう。
評価が終わったら一式を保存しておこう。次のQwen 4モデルや小型のオープンウェイトモデルが公開されたとき、同じタスクを使えば1週間ではなく1日で比較できる。
オープン ウェイトまたはより安価なベースラインが必要な場合
Qwen4-Maxはクローズドモデルだ。アリババは同世代の小型Qwen 4モデルをオープンウェイトで公開するとしているが、時期は示していない。ウェイトの公開が必須なら、このモデルは要件を満たさないため、小型モデルの公開を待って判断する必要がある。
最先端モデルの品質を必要としない大量処理では、当社プランのDeepSeek Flash(倍率1倍)が安価な比較対象となる。同じプランで使えるトークン数が多く、同じテスト環境で比較できる。安価なモデルを標準にし、長時間かかる重要なタスクではQwen4-Maxを使う方法もある。
モデルを比較するときは、テスト環境を同じに保とう。あるエージェントでは弱く見えるモデルが別のエージェントでは強く見えることもある。モデルと環境を同時に変えると、どちらが結果に影響したのか分からない。
よくある質問
Qwen4-Max はリリースされていますか?
はい。アリババは、Qwen 4 ファミリーの最初のモデルとして、2026 年 11 月 16 日に Qwen4-Max をリリースしました。この API は、従量課金制とトークン プラン課金の QwenCloud で利用でき、このモデルは Qwen Studio、QwenWork、Qoder でも利用できます。
Qwen4-Max の費用はいくらですか?
発表時の料金は100万トークンあたり入力1.50ドル、出力4.50ドル、暗黙キャッシュ0.075ドル。予算を立てる前に提供元の最新料金を確認しよう。推論トークンは出力として課金される。
Qwen4-Max はオープンソースですか?
いいえ。アリババによれば、Qwen4-Max 自体はオープンソースではなく、同じ世代でトレーニングされた小型の Qwen 4 モデルがオープンウェイトで後にリリースされる予定です。
Qwen4-Max はすべてのベンチマークで最高のモデルですか?
いいえ。提供元の比較ではDeepSWE v1.1、Agents’ Last Exam v1.1、BioMysteryBench、HLAB-Vals-1.1で首位だったが、Terminal-Bench 4.0ではKimi K3.1(48.5対67.2)、ProgramBenchではOpus 5.5(31.5対65.0)に後れを取った。チャート理解とAgentArenaでも比較対象の下位に位置する。
100万トークンのコンテキスト長があれば、全体から情報を正確に取り出せる?
いいえ。コンテキスト長は入力できる容量の上限であり、情報を正確に取り出せるか、応答にかかる時間、費用を示すものではない。長文の冒頭・中盤・末尾に情報を置いて検索を試し、古い文書と矛盾する新しい文書も含めて検証しよう。
マルチモデル コーディング プランを通じて Qwen4-Max を使用できますか?
当社のシンガポールゲートウェイでは、qwen4-max-previewを15倍のポイント倍率で掲載している。正式版の公開によって提供元のラインアップが変わっているため、クライアントを設定したりプランを購入したりする前に、最新のモデル一覧を確認しよう。
トークンの節約により、請求額が 50% 安くなりますか?
必ずしもそうはならない。24〜49%という削減率は、特定のベンチマークと推論レベルで提供元が測定したものだ。実際の節約額は、推論トークンの使用量、入力の繰り返し、タスクに必要な試行回数によって変わる。
正式版を呼び出せるようになった今、必要なのは自分の業務での比較だ。弱点を重点的に試し、結果とコストを記録して、移行するか判断しよう。