Atualizado em 16 de novembro de 2026 · Cameron Voss e West Mao
Qwen4-Max: custo, benchmarks e como avaliá-lo (novembro de 2026)
Preços de tabela anunciados, verificados em 16 de novembro de 2026. Os tokens de raciocínio são cobrados como saída.
- 11 de novembroQwen 4 anunciado com uma prévia do Max.
- 11 a 15 de novembroQoDuck é executado anonimamente em Qoder.
- 16 de novembroQwen4-Max vem com API com cobrança conforme o uso.
- PróximoModelos Qwen 4 menores prometidos com pesos abertos.
A sequência de visualização ao lançamento. A última caixa é uma promessa, não uma data.
O que mudou desde a pré-visualização
Cinco dias antes do lançamento, o único modelo Qwen 4 disponível era uma prévia com data de encerramento anunciada. Esse período terminou antes do previsto: em 16 de novembro de 2026, o Alibaba lançou o Qwen4-Max com preços de tabela, API com cobrança conforme o uso e resultados de benchmarks. Se o seu plano de testes considerava o prazo de 25 de novembro, essa data deixou de ser a principal preocupação. Agora, a questão é se o modelo lançado atende às suas tarefas.
O formato da oferta também mudou. A prévia era apenas do Token Plan, e o guia publicado antes deste lançamento dizia isso. Qwen4-Max agora pode ser chamado com cobrança conforme o uso ou através do Token Plan, e está disponível em Qwen Studio, QwenWork e Qoder. O modelo não é de código aberto; Alibaba diz que modelos menores do Qwen 4 seguirão com pesos abertos treinados da mesma maneira.
Uma consequência prática: não carregue um ID de modelo a partir de uma integração de visualização. Releia a lista de modelos ativos no serviço que você usa, porque a versão estável é uma oferta diferente, mesmo quando o nome parece semelhante.
Quanto custa, em dólares e em pontos
Os preços de tabela são US$ 1,50 por milhão de tokens de entrada, US$ 4,50 por milhão de tokens de saída e US$ 0,075 por milhão de tokens no cache implícito. A tarifa do cache corresponde a 5% da tarifa de entrada nova, tornando o contexto reutilizado bem mais barato.
Considere uma tarefa com 1 milhão de tokens de entrada e 200 mil de saída: ela custa US$ 2,40 quando toda a entrada é nova. Se toda a entrada vier do cache, o custo é US$ 0,975. A diferença mostra por que a ordem dos prompts e a reutilização de sessões merecem atenção no cálculo dos custos.
Um trabalho de 1 milhão de entrada e 200 mil saídas
Saída com preço de US$ 4,50 por milhão. Ilustrativo, antes das ferramentas e novas tentativas.
Os acessos ao cache dependem da estrutura do prompt e do comportamento do provedor. Uma leitura que perde o cache é cobrada como entrada nova.
Nosso gateway Multi-Model cobra em pontos. A taxa publicada para qwen4-max-preview é de 15×: cada token de entrada ou saída consome 15 pontos. Assim, a tarefa de 1,2 milhão de tokens custa 18 milhões de pontos. Todos os modelos do plano compartilham o saldo. Confira as cotas e a disponibilidade do modelo antes de contratar.
Pontos por 1 milhão de tokens
Pontos = (tokens de entrada + tokens de saída) × multiplicador.
Os preços do dólar acima e a taxa de pontos abaixo são sistemas de cobrança diferentes. Compare-os pelo custo por resultado aceito, não pela tarifa anunciada.
Em que o modelo se destaca e quais tarefas suas se parecem com esses testes
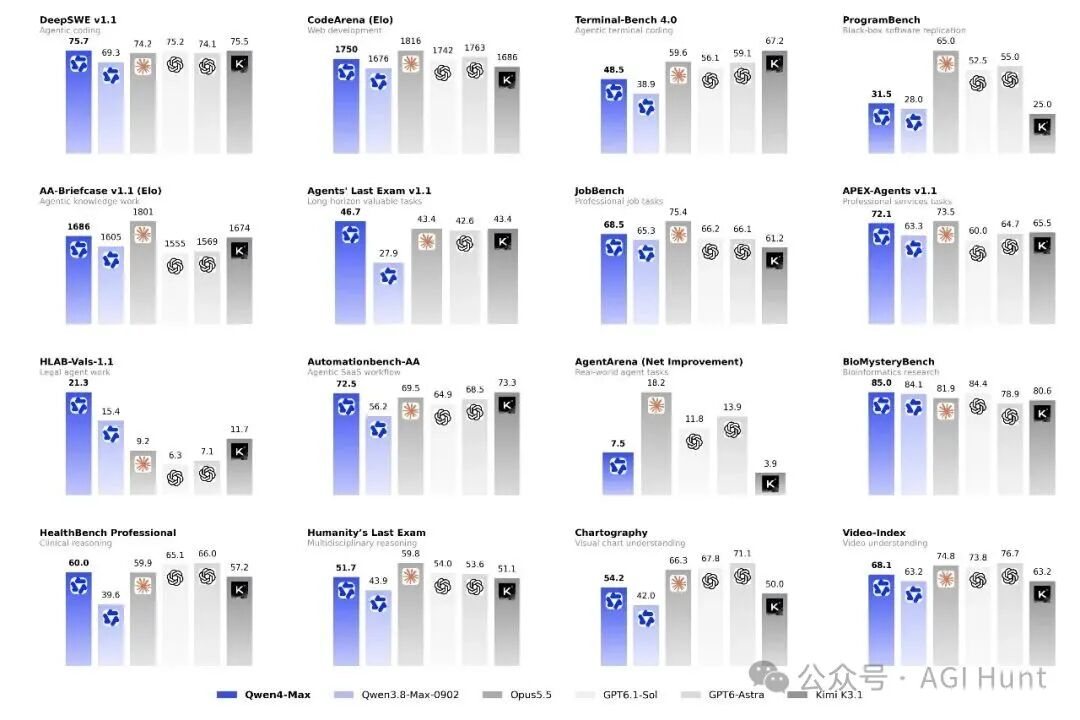
A tabela de lançamento dá ao Qwen4-Max o primeiro lugar no DeepSWE v1.1 com 75,7, Agents' Last Exam v1.1 com 46,7, BioMysteryBench com 85,0 e HLAB-Vals-1.1 com 21,3. O último é um benchmark de agente jurídico, onde o Opus 5.5 tem pontuação de 9,2.
Esses quatro resultados mostram um perfil de desempenho, não uma classificação geral. Engenharia de software, tarefas longas de agentes, pesquisa em biologia e trabalho jurídico baseado em documentos geram entregas que podem ser conferidas com as fontes. Os exemplos do Alibaba seguem essa linha: due diligence com documentos variados, planilhas financeiras com células rastreáveis e registros de UTI relacionados às prescrições médicas.
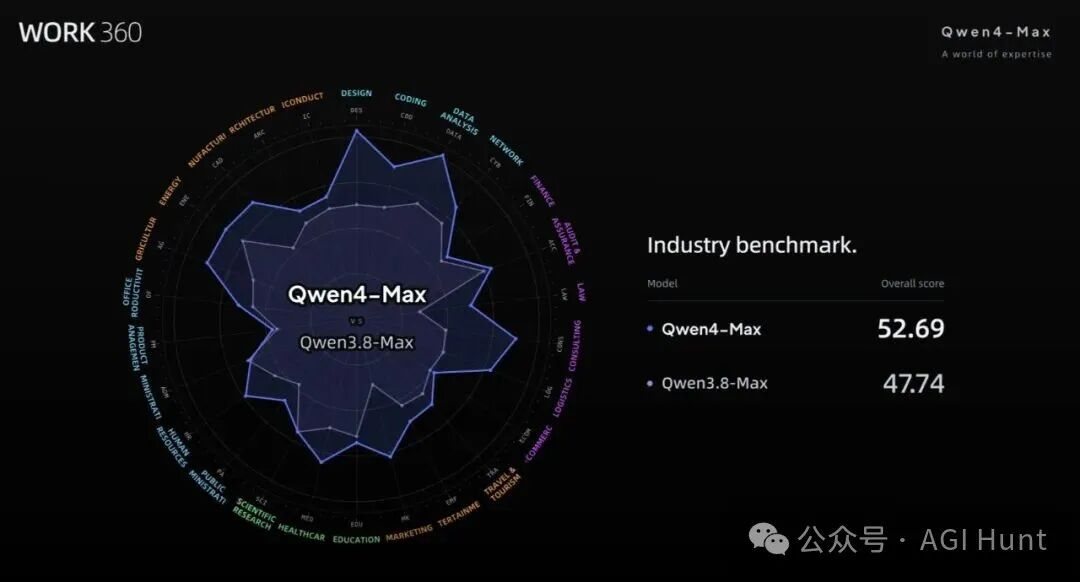
O fornecedor também construiu o Work360 para este lançamento, com 26 domínios de primeiro nível, 182 subdomínios e 721 áreas especializadas. Qwen4-Max pontua 52,69 contra 47,74 da geração anterior, cerca de 10%. Um benchmark que o fornecedor projetou e pode revisar é uma evidência fraca por si só, mas o detalhamento do domínio é útil para escolher qual tarefa testar primeiro.
Onde o modelo fica atrás e como testar esses pontos
Duas perdas se destacam. Terminal-Bench 4.0 pontua 48,5 contra Kimi K3.1 com 67,2, e ProgramBench, que pede uma reprodução funcional do software existente, pontua 31,5 contra Opus 5.5 com 65,0. A compreensão do gráfico e o AgentArena o colocam no final da mesma comparação.
Esses são os três eixos que merecem um teste dedicado antes de uma migração. Se o seu agente vive em um shell, entregue a ele uma tarefa que precisa de uma sequência de comandos, uma falha e uma recuperação. Se você mantém um serviço legado, solicite uma reescrita compatível com o comportamento em um conjunto de testes que você já possui. Se o seu fluxo de trabalho começar com um gráfico, uma captura de tela do painel ou um diagrama, verifique se o modelo lê os valores corretamente em vez de descrever as formas.
A afirmação de eficiência de token e como verificá-la
O lançamento afirma que o pensamento XHigh e High usa cerca de 24% e 35% menos tokens do que a geração anterior no Work360, e cerca de 48% e 49% menos no Terminal-Bench 4.0. Juntamente com as taxas mais baixas, isso move a tarefa média do Work360 de US$ 4,43 para US$ 1,67, uma redução de 62%.
Não trate essa porcentagem como um desconto direto na sua conta. A economia vem da redução de tokens de raciocínio e depende do esforço que seus prompts exigem. Para a mesma tarefa nos dois modelos, registre tokens de entrada, entrada em cache, saída e raciocínio. Conte os tokens por resultado aceito, não por tentativa: um modelo 30% mais barato por token pode sair mais caro se precisar de duas tentativas extras.
Faça o mesmo em Low e XHigh. Se Baixo preencher a maior parte da lacuna de qualidade em suas tarefas, a configuração padrão será a cara.
Trabalho de longo horizonte: o que o Live Delivery muda nos testes
O lançamento adiciona Live Delivery: em vez de trabalhar silenciosamente até o fim, o agente retorna uma primeira versão utilizável antecipadamente e depois itera, para que você possa corrigir a direção antes da parte cara. O Alibaba abriu o código-fonte do complemento Qwen-Live-Delivery-Plugin.
Isso muda a aparência de um bom teste. Em vez de pontuar apenas o artefato final, registre quando a primeira entrega chegou, se ela era utilizável e quantas intervenções você fez antes da última versão. Um modelo que atinge um bom estado final após quatro correções é um agente pior do que aquele que atinge um rascunho utilizável em uma passagem, mesmo quando os resultados finais parecem idênticos.
As demonstrações de lançamento baseiam-se neste padrão: um jogo construído e depois autotestado, uma linha de produção modelada e depois corrigida contra simulação, uma molécula projetada, sintetizada e revisada através de quatro loops.
Seis demonstrações como modelos de tarefas
A lista de demonstração é mais útil como um conjunto de modelos de teste do que como prova. Cada linha abaixo é algo que você pode reduzir para uma tarefa que sua equipe pode avaliar.
Em telas menores, role a tabela para os lados.
| Demonstração | O que o fornecedor relatou | Modelo que você pode executar |
|---|---|---|
| Blender e compilações de jogos | Cenas desde um modelo branco até uma tomada renderizada; Jogos Unreal Engine e Unity 6, um empacotado para Android | Dê ao agente uma ferramenta que ele possa executar e, em seguida, solicite uma versão jogável e uma aprovação de autoteste |
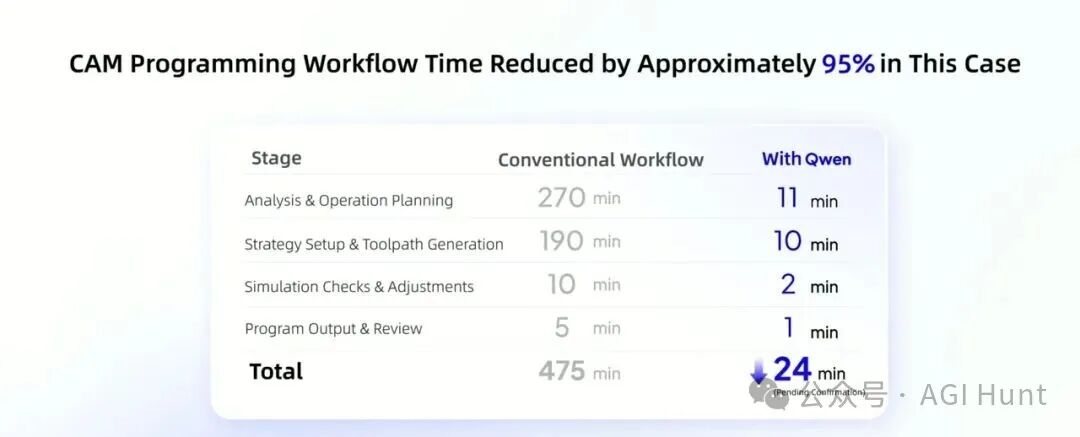
| Fabricação | Linha 3D a partir de um layout 2D, comissionamento virtual de CLP, caminhos de ferramentas; De 475 para 24 minutos por peça | Uma conversão de geometria ou CAD com uma verificação de simulação e um tempo de ciclo mensurável |
| Materiais | Nova molécula para fluido de arrefecimento projetada e sintetizada após quatro loops de projeto e teste | Um loop de pesquisa com uma etapa de validação real, não uma resposta de texto |
| Projeto de medicamentos | 454 chamadas de ferramentas, 3.239 avaliações, 24 candidatos, 3,6x de afinidade prevista | Uma longa execução orientada por ferramentas onde o progresso só é real se a função de pontuação se mover |
| Finanças | 90 ferramentas MCP, Excel e deck com rastreabilidade do gráfico à célula | Uma tarefa de dados de múltiplas fontes onde cada figura deve ser rastreada até uma célula |
| Legal e médica | Devida diligência de 198 documentos com citações; seis dias de registros de UTI com correspondência por linha | Uma pilha de documentos própria onde cada conclusão precisa de uma fonte |
Resultados relatados pelo fornecedor, reescritos como tarefas que você pode avaliar com seus próprios dados.
Um plano de avaliação de uma semana
Em telas menores, role a tabela para os lados.
| Dia | O que executar | O que registrar |
|---|---|---|
| 1 | Um repositório, um ambiente de teste, dois modelos e um nível de esforço | ID do modelo, provedor, região, data, nível de esforço, configuração de contexto |
| 2 | Um teste com falha, um recurso de vários arquivos, uma sequência de shell com uma falha forçada | Taxa de aprovação em testes escritos primeiro, novas tentativas, erros de ferramenta, etapas de recuperação |
| 3 | Uma reescrita compatível com comportamento em um conjunto existente | Regressões, falhas ocultas, tempo de revisão |
| 4 | Um gráfico ou tarefa de captura de tela, além de uma entrada longa com fatos no início, meio e fim | Valores lidos corretamente, contradições detectadas, recuperação em cada posição |
| 5 | As mesmas tarefas em Low e XHigh | Tokens por resultado aceito, tokens de raciocínio, dólares ou pontos por resultado aceito |
| 6 | Uma tarefa de longa duração com Live Delivery | Tempo para a primeira versão utilizável, intervenções, qualidade final |
| 7 | Repetir o vencedor duas vezes, arquivar rastreamentos, nomear o padrão | Prompts, configurações, resultados, pontuações, datas, gastos |
Um ponto de partida. Corte o que não se parece com o seu trabalho e guarde os registros.
Arquive o pacote quando terminar. O próximo lançamento do Qwen 4, incluindo os modelos menores de peso aberto, pode então ser medido em relação às mesmas tarefas em um dia em vez de uma semana.
Se você precisar de pesos abertos ou uma linha de base mais barata
Qwen4-Max está fechado. O Alibaba promete modelos Qwen 4 menores com pesos abertos da mesma geração e não informa data. Se os pesos abertos são um requisito e não uma preferência, esta versão não o satisfaz, e uma decisão deve esperar pelos modelos menores.
Para tarefas em grande volume que não exigem um modelo de ponta, o DeepSeek Flash continua sendo uma referência mais barata no nosso plano, com multiplicador de 1×. A mesma categoria compra bem mais tokens. Compare os modelos no mesmo ambiente de teste. Uma opção é usar o modelo mais barato como padrão e recorrer ao Qwen4-Max para tarefas longas e de maior valor.
Ao comparar modelos, mantenha o mesmo ambiente de teste. Um modelo pode parecer mais fraco em um agente e mais forte em outro; se você alterar os dois ao mesmo tempo, não saberá qual mudança causou a diferença.
Perguntas frequentes
O Qwen4-Max foi lançado?
Sim. O Alibaba lançou o Qwen4-Max em 16 de novembro de 2026, como o primeiro modelo da família Qwen 4. A API está disponível no QwenCloud com cobrança conforme o uso e Token Plan, e o modelo também está disponível no Qwen Studio, QwenWork e Qoder.
Quanto custa o Qwen4-Max?
Os preços de tabela anunciados são US$ 1,50 por milhão de tokens de entrada, US$ 4,50 por milhão de tokens de saída e US$ 0,075 por milhão de tokens de cache implícito. Verifique os preços em tempo real do fornecedor antes de fazer o orçamento e lembre-se de que os tokens de raciocínio são cobrados como saída.
O Qwen4-Max é de código aberto?
Não. Alibaba diz que o Qwen4-Max em si não é de código aberto e que modelos menores do Qwen 4 treinados com a mesma geração serão lançados posteriormente com pesos abertos.
O Qwen4-Max é o melhor modelo em todos os benchmarks?
Não. Na comparação do próprio fornecedor, ele lidera DeepSWE v1.1, Agents' Last Exam v1.1, BioMysteryBench e HLAB-Vals-1.1, mas segue Kimi K3.1 no Terminal-Bench 4.0 (48,5 versus 67,2) e Opus 5.5 no ProgramBench (31,5 versus 65,0), e fica próximo ao final da compreensão do gráfico e AgentArena.
Uma janela de contexto de 1 milhão de tokens garante recuperação confiável em toda a extensão?
Não. A janela de contexto indica capacidade, não a confiabilidade da recuperação, a latência ou o custo. Teste a recuperação com informações no início, no meio e no fim de uma entrada longa e inclua um documento mais recente que contradiga um anterior.
Posso usar o Qwen4-Max por meio do Multi-Model Coding Plan?
Nosso gateway publica qwen4-max-preview em 15x pontos no gateway de Singapura. O lançamento estável alterou a oferta do provedor, portanto, verifique a lista de modelos ativos antes de configurar um cliente ou comprar um plano.
A economia de tokens significa uma conta 50% mais barata?
Não automaticamente. As reduções de 24% a 49% são medições do fornecedor em benchmarks específicos em níveis de pensamento específicos. Sua economia depende de quanto do seu uso é de tokens de raciocínio, de quantas entradas são repetidas e de quantas tentativas uma tarefa precisa.
A janela de visualização acabou. O que resta é um modelo que você pode chamar, um preço que você pode calcular e duas linhas de referência que indicam onde procurar primeiro. Execute a semana, mantenha os rastreamentos e deixe seu próprio repositório decidir.