Qwen4-Max ist da: 2,4 Billionen Parameter, 1,50 US-Dollar pro Million Eingabetoken und sechs Branchen-Demos
TL;DRAlibaba veröffentlichte am 16. November 2026 Qwen4-Max, das erste Modell der Qwen 4-Familie. Es handelt sich um ein sparsames MoE-Modell mit 2,4T Gesamtparametern, 71B aktivierten pro Token, nativer Vision-Eingabe und einem 1M-Token-Kontextfenster. Der Preis beträgt 1,50 US-Dollar pro Million Eingabe-Tokens, 4,50 US-Dollar pro Million Ausgabe-Tokens und 0,075 US-Dollar für impliziten Cache, was günstiger ist als bei Qwen3.8-Max. Der offizielle Vergleich zeigt erste Plätze bei DeepSWE v1.1, Agents' Last Exam v1.1, BioMysteryBench und einem Legal-Agent-Benchmark sowie deutliche Verluste bei Terminal-Bench 4.0 und ProgramBench. Die API ist live auf QwenCloud mit Pay-as-you-go- und Token-Plan-Abrechnung verfügbar, und das Modell ist nicht Open Source.
Von Cameron Voss und West Mao
Was gestartet wurde und wo Sie es verwenden können
Alibaba veröffentlichte Qwen4-Max am 16. November 2026. Es ist das erste Modell in der Qwen 4-Familie: eine neue, sparse Mixture-of-Experts-Architektur mit 2,4 Billionen Gesamtparametern und 71 Milliarden Aktivierungen pro Token, nativer Vision-Eingabe und einem Kontextfenster für eine Million Token. Die offizielle Positionierung ist ein „KI-Teamkollege“ für die Ausführung über einen längeren Zeitraum bei realer Arbeit und nicht ein Chat-Modell.
Die API ist live auf QwenCloud, wo sie mit Pay-as-you-go-Abrechnung oder über den Token-Plan aufgerufen werden kann. Direktzugriff gibt es auch in Qwen Studio, QwenWork und Qoder. Qwen4-Max selbst ist kein Open Source; Laut Alibaba werden kleinere Qwen 4-Modelle später mit offenen Gewichten derselben Generation veröffentlicht.
Preis: günstiger als das Modell, das es ersetzt
Qwen4-Max kostet 1,50 US-Dollar pro Million Eingabetoken und 4,50 US-Dollar pro Million Ausgabetoken. Der Preis für den impliziten Cache beträgt 0,075 US-Dollar pro Million Token. Das sind laut Alibaba rund 70 % weniger als zuvor und 5 % des Preises für neue Eingaben. Alibaba stellt die Tarife als Preissenkung gegenüber Qwen3.8-Max dar.
| Qwen4-Max-Listenpreis | USD pro 1 Mio. Token |
|---|---|
| Input | 1,50 $ |
| Output | 4,50 $ |
| Impliziter Cache | 0,075 $ |
Preise aus der Ankündigung vom 16. November. Überprüfen Sie vor der Budgetierung die Live-Preisseite des Anbieters.
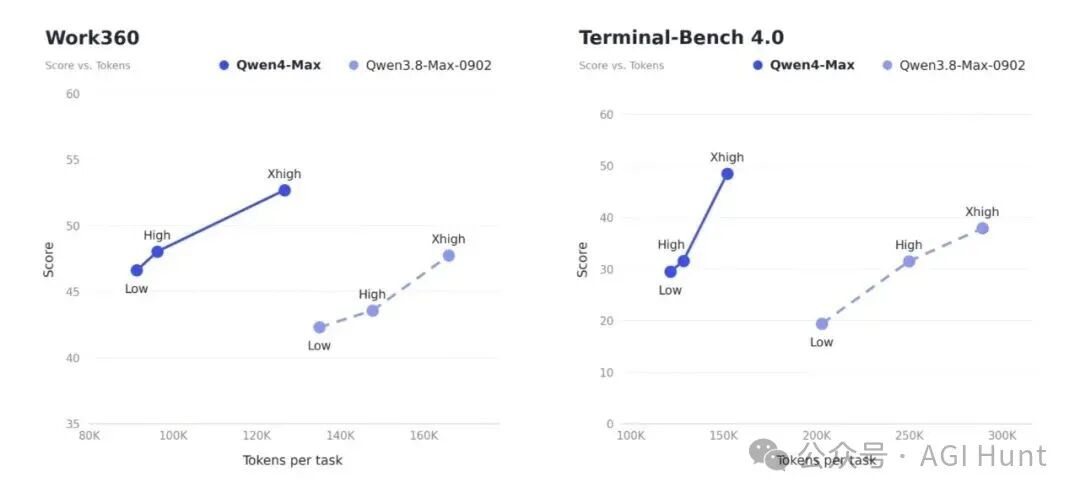
Token-Effizienz ist genauso wichtig wie der Preis. Bei Work360 gibt der Anbieter an, dass die Denkstufen XHigh und High etwa 24 % bzw. 35 % weniger Token verbrauchen als die vorherige Generation; Auf Terminal-Bench 4.0 beträgt die Reduzierung etwa 48 % bzw. 49 %. In Kombination mit den niedrigeren Tarifen sinken die durchschnittlichen Kosten einer Work360-Aufgabe von 4,43 $ auf 1,67 $, was einem Rückgang um 62 % entspricht.
Benchmarks: erster Platz bei vier Tests, letzter Platz bei zwei
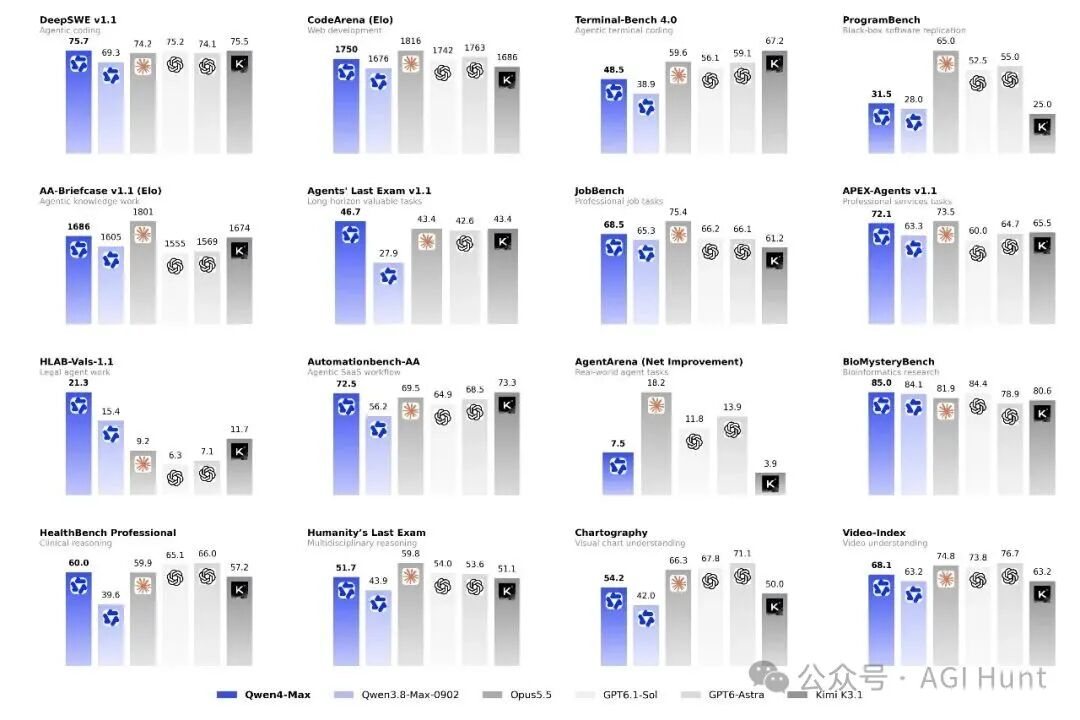
Alibaba verglich Qwen4-Max mit Opus 5.5, GPT-6.1 Sol, GPT-6 Astra und Kimi K3.1. Es belegt den ersten Platz bei DeepSWE v1.1 mit 75,7, Agents' Last Exam v1.1 mit 46,7, BioMysteryBench mit 85,0 und dem Legal-Agent-Benchmark HLAB-Vals-1.1 mit 21,3, was mehr als dem Doppelten des Opus 5.5-Scores von 9,2 entspricht.
Die gleiche Tabelle zeigt auch, wo es verliert. Auf Terminal-Bench 4.0 erreicht er 48,5 gegen Kimi K3.1 bei 67,2. Bei ProgramBench, bei dem ein Modell aufgefordert wird, eine vorhandene Software zu reproduzieren, erreicht es 31,5 Punkte gegenüber Opus 5.5 mit 65,0 Punkten. Diagrammverständnis und AgentArena platzieren es am Ende der Gruppe.
| Benchmark | Qwen4-Max | Vergleich | Einordnung |
|---|---|---|---|
| DeepSWE v1.1 | 75,7 | Führt das Vergleichsfeld an | Software-Engineering-Aufgaben |
| Agents' Last Exam v1.1 | 46,7 | Führt das Vergleichsfeld an | Langhorizont-Agentenarbeit |
| BioMysteryBench | 85,0 | Führt das Vergleichsfeld an | Biologische Forschungsaufgaben |
| HLAB-Vals-1.1 | 21,3 | Opus 5.5: 9,2 | Legal Agent-Arbeit |
| Terminal-Bench 4.0 | 48,5 | Kimi K3.1 bei 67,2 | Terminal- und Shell-Aufgaben |
| ProgramBench | 31,5 | Opus 5.5 bei 65,0 | Reproduktion bestehender Software |
Vom Anbieter gemeldeter Vergleich aus der Markteinführungsankündigung. Es wurde keine unabhängige Replikation veröffentlicht.
Work360: 52,69 Punkte bei einem Benchmark, den Alibaba erstellt hat
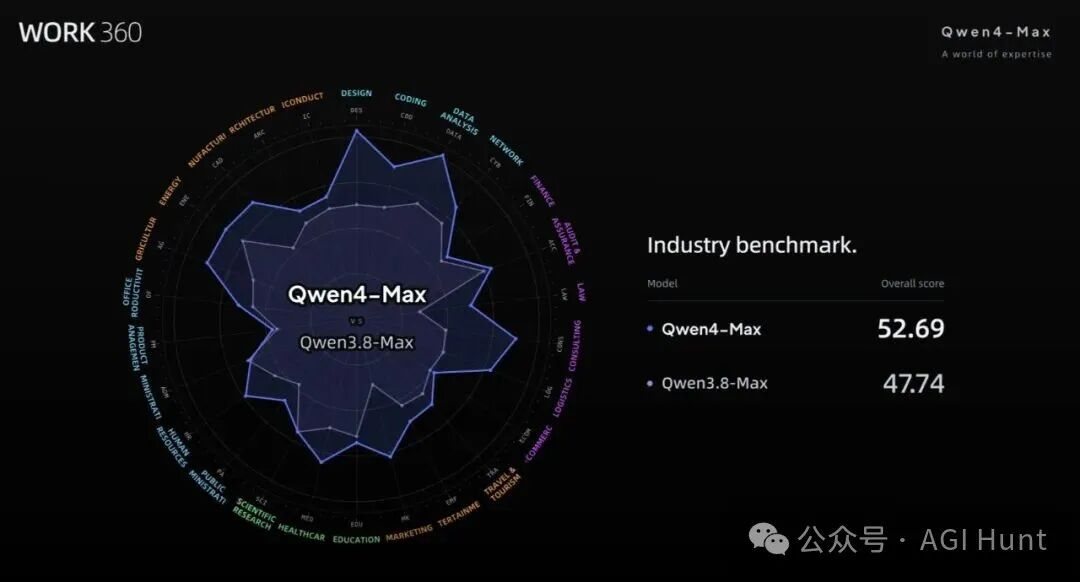
Um die Arbeit und nicht die Prüfungsantworten zu messen, hat das Qwen-Team seinen eigenen abgestuften Arbeits-Benchmark, Work360, mit 26 Domänen der ersten Ebene, 182 Unterdomänen und 721 Fachbereichen für Design, Kodierung, Finanzen, Recht, Medizin, Bildung, Logistik und Energie. Qwen4-Max erreicht einen Wert von 52,69, gegenüber 47,74 bei der vorherigen Generation, was einem Zuwachs von etwa 10 % entspricht.
Ein vom Anbieter entwickelter Benchmark ist nützlicher Kontext und schwache Beweise zugleich. Es ist die einzige öffentliche Messung, die so viele Auftragstypen abdeckt, und sie ist auch der Maßstab, den der Anbieter gewählt hat und den er überarbeiten kann. Lesen Sie die Rangliste und führen Sie dann Ihre eigenen Aufgaben aus.
Wählen Sie zwischen offiziellem Zugang und einem Gateway? Lesen Sie den Qwen 4-Abonnementleitfaden für die aktuellen Routen, Modellliste und Einrichtungsschritte.
Architektur: Sparse Attention, gesteuerte Residualverbindungen und ein größeres Embedding
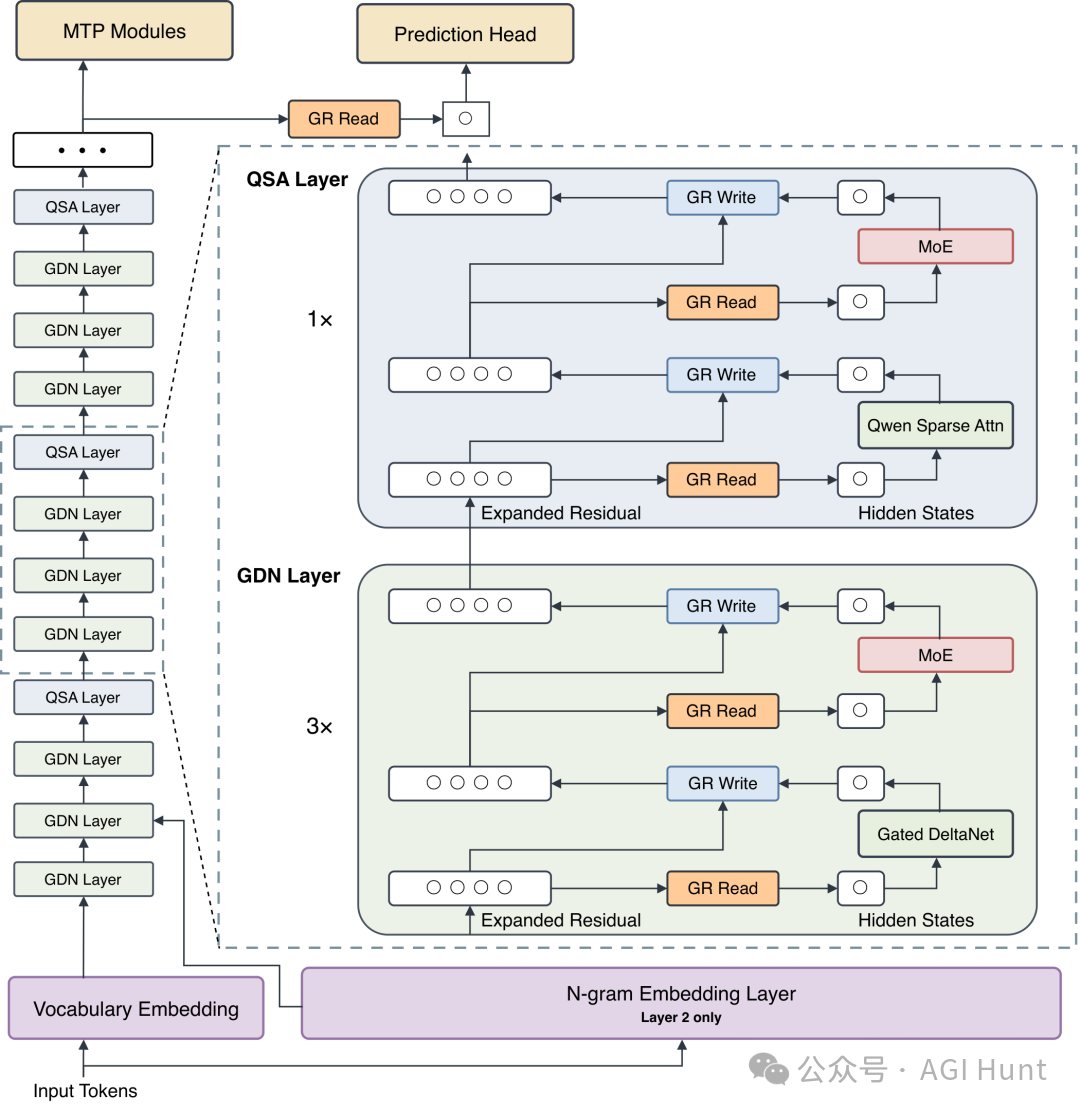
Die Architektur ändert sich an drei Stellen: Die Attention kombiniert Gated DeltaNet (GDN) und Qwen Sparse Attention (QSA) im Verhältnis von drei GDN-Schichten zu einer QSA-Schicht. GDN verdichtet den bisherigen Kontext zu einem Zustand fester Größe; QSA wählt mit einem schlanken Indexer relevante Mikroblöcke aus. So sinkt der Rechenaufwand für lange Sequenzen. Die Residualverbindungen bestehen aus vier parallelen, gesteuerten Pfaden mit dynamischen Lese- und Schreib-Gates pro Schicht. Das soll das Training stabilisieren. Die zweite Schicht ergänzt ein N-Gramm-Embedding mit 328 Milliarden zusätzlichen Parametern, das den Rechenaufwand kaum erhöht.
Alibaba zufolge traten beim Training des Modells mit 2,4 Billionen Parametern keine Verlustspitzen auf. Das Basismodell nutze 25 % weniger aktive Parameter als Qwen3.8-Max-Base und erreiche je nach Bereich 5 bis 13 % niedrigere Bits-per-Byte-Werte. Diese Angaben beziehen sich auf das Training; welche Ergebnisse Ihre eigenen Aufgaben erzielen, müssen Sie selbst prüfen.
Sechs Branchendemos in der Markteinführung
Ein Benchmark kann diese Demos nicht ersetzen. Alibaba setzte das Modell in verschiedenen Bereichen ein und berichtete über die jeweiligen Ergebnisse. Es handelt sich um vom Anbieter ausgewählte Beispiele; prüfen Sie, welche davon Ihren eigenen Aufgaben ähneln.
3D und Spiele. Das Modell bedient Blender direkt für Modellierung, Szenenaufbau, Materialien, Beleuchtung und Rendering und wechselt von einem groben weißen Modell zu einer filmischen Aufnahme. Es erstellt auch Spiele in Unity, Unreal Engine und Godot, führt sie aus, um sich selbst zu testen, und passt Kameraführung, Animation und Treffer-Feedback anhand dessen an, was es sieht. Die Beispiele sind ein Xianxia-Spiel der Unreal Engine, Yunguanxing, mit einem Bosskampf gegen einen Panda, und ein Unity 6 West Lake-Rennspiel, das als installierbare Android-Version verpackt wurde.
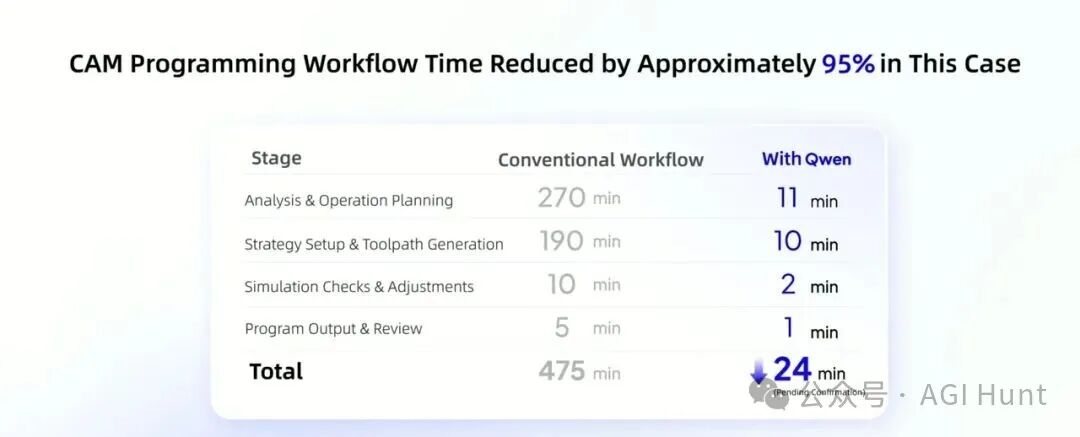
Fertigung. Bei SANF und Pacific Union arbeitete das Modell in realen Produktionsumgebungen. Es baute eine 3D-Produktionslinie aus einem 2D-Layout und Prozessparametern unter Verwendung einer vorhandenen Gerätebibliothek auf, simulierte Zykluszeiten und führte eine virtuelle SPS-Inbetriebnahme durch. Auf Teileebene entwarf es Türbaugruppen und Reibräder, plante Bearbeitungssequenzen, generierte Werkzeugwege und nutzte Simulationen, um Über- und Unterschnitte vor der Bearbeitung zu ermitteln. Das gemeldete Ergebnis: Die Programmierzeit für ein einzelnes Werkstück sank von etwa 475 Minuten auf 24 Minuten, was einer Reduzierung um 95 % entspricht.
Wissenschaftliche Entdeckung. Das Modell entwarf und synthetisierte ein neues Kühlmittelmolekül für die Hochleistungs-Chipkühlung der nächsten Generation. Verbunden mit der Nass- und Trockenlaborplattform Mira von Deep Principle lief es 48 Stunden lang autonom: Es wurde die technische Route untersucht, ein Kandidatenraum mit 2,7 Millionen Molekülen erstellt, dann Strukturen gefiltert, Eigenschaften vorhergesagt, First-Principles-Berechnungen und Retrosyntheseanalysen durchgeführt und ein automatisiertes Nasslabor angewiesen, Reagenzien vorzubereiten, zu synthetisieren, zu trennen, zu reinigen und zu testen. Nach vier Design-, Synthese-, Test- und aktiven Lernrunden wurde eine physikalisch verifizierte Probe erstellt.
Arzneimitteldesign. Auf der PharmMaster-Plattform von Deep Principle arbeitete das Modell am NLRP3-Ziel im Zusammenhang mit der Alzheimer-Krankheit. Es wurden 454 Werkzeugaufrufe durchgeführt, 3.239 rechnerische Auswertungen durchgeführt und 24 Kandidatenmoleküle entworfen und verfeinert; Die endgültige Auswahl hat eine vorhergesagte Bindungsaffinität, die etwa dem 3,6-fachen des Referenzmoleküls entspricht.
Finanzen. Im Aktienresearch wurden in einem Aufruf 90 MCP-Tools zur Erfassung von Daten zu A-Aktien, Hongkong, USA, Anleihen, Fonds und Derivaten abgerufen und anschließend eine Excel-Arbeitsmappe und ein bearbeitbares Foliendeck bereitgestellt, wobei jedes Diagramm auf die Arbeitsmappe zurückführbar war und Zell-Hyperlinks auf die Quelldaten verweisen.
Rechtliches. Bei der Due-Diligence-Prüfung vor dem Börsengang gingen 198 Quelldokumente mit inkonsistenten Formaten und Dateinamen ein. Das Modell benannte sie nach Inhalt um, legte sie in 14 Ordnern ab, überprüfte Gewerbeanmeldungen, geistiges Eigentum, Rechtsstreitigkeiten und Kreditunterlagen und erstellte einen 86-seitigen Bericht mit mehr als 60.000 Zeichen mit einer Quellenangabe für jede Schlussfolgerung.
Medizinisch. In einem Gespräch las es sechs Tage Intensivaufzeichnungen, darunter Dutzende von Laborblättern, mehr als 10.000 Zeichen Fortschrittsnotizen und 1.433 Rohbilder. Es entsandte Subagenten, um Hunderte von CT-Schnitten parallel zu überprüfen, und seine vier Empfehlungen stimmten Punkt für Punkt mit den tatsächlichen Anweisungen des Arztes am selben Tag überein.
| Domäne | Aufgabe | Behauptetes Ergebnis |
|---|---|---|
| 3D und Spiele | Blender-Modellierung und -Rendering; Unreal Engine- und Unity-Spiele | Fertig gestellte Szenen, ein spielbarer Android-Build |
| Fertigung | 3D-Produktionslinie, virtuelle SPS-Inbetriebnahme, Werkzeugwege | Von 475 auf 24 Minuten pro Werkstück |
| Materialien | Kühlmittelmoleküldesign auf einer Nass- und Trockenlaborplattform | Synthetisierte Probe nach vier Durchläufen |
| Arzneimitteldesign | NLRP3-Kandidaten auf PharmMaster | 24 Kandidaten, 3,6-fache vorhergesagte Affinität |
| Finanzen | 90 MCP-Tools, Excel und Decklieferung | Diagramme rückverfolgbar auf Quellzellen |
| Recht | 198-Dokument-Due-Diligence | 86 Seiten mit Quellenangaben für jede Aussage |
| Medizin | Sechs Tage Intensivaufzeichnungen und CT-Überprüfung | Vier Empfehlungen, die den ärztlichen Anordnungen entsprechen |
Alle Ergebnisse stammen aus vom Anbieter beschriebenen Demonstrationen. Es sind keine vergleichenden Tests, und die Angaben wurden nicht unabhängig geprüft.
Der 24-Stunden-Agent und das Live-Delivery-Plugin
Qwen4-Max soll länger laufende Agentenaufgaben unterstützen. Mit Live Delivery liefert der Agent früh eine erste nutzbare Version und arbeitet danach iterativ weiter. So können Nutzer rechtzeitig eingreifen und die Richtung korrigieren. Das begleitende Qwen-Live-Delivery-Plugin ist Open Source.
Alibaba Cloud berichtet auch, dass es das Modell intern verwendet, um seine eigene Rechenplanung zu optimieren: Die Kosten für Annotationsmodellaufrufe sanken im Durchschnitt um 10,42 %, und die Offline-CPU-Neuplanung wurde mehr als 14,61-mal schneller gelöst. Interne Zahlen dieser Art sind von außen schwer zu überprüfen und messen die eigene Arbeitsaufgaben des Anbieters.
Sicherheitsaussagen
Beim Training für Code wurden neben funktionalen Prüfungen auch Sicherheitsprüfungen eingesetzt. Im Last Secure Code Bench stieg die Erfolgsquote für zugleich korrekten und sicheren Code auf Funktionsebene von 22,0 % auf 31,8 %. Der Anteil, der die Prüfungen auf Funktions-, Datei- und Repository-Ebene bestand, stieg von 8 % auf 14,7 %. Alibaba zufolge wurden außerdem Trainingsdaten entfernt, die Angriffsfähigkeiten verbessern könnten.
Was dieser Start nicht klärt
Vier Dinge bleiben offen. Die Benchmark-Tabelle wird vom Hersteller durchgeführt, ohne unabhängige Replikation der Terminal-Bench- oder ProgramBench-Lücken. Bei den Demos handelt es sich um ausgewählte Läufe, und keiner von ihnen meldet eine Ausfallrate. Die Token-Einsparungen von 24 % bis 49 % hängen von der Denkstufe und der Aufgabe ab, es handelt sich also nicht um einen pauschalen Rabatt. Und das Modell ist geschlossen: Wenn Sie Gewichte benötigen, ist dies nicht die Qwen-Version für Sie, obwohl kleinere offene Modelle versprochen werden.