Qwen4-Max é lançado com 2,4 trilhões de parâmetros, entrada a US$ 1,50 e seis demonstrações setoriais
TL;DRAlibaba lançou o Qwen4-Max em 16 de novembro de 2026, o primeiro modelo da família Qwen 4. É um modelo MoE esparso com parâmetros totais de 2,4T, 71B ativados por token, entrada nativa de imagens e uma janela de contexto de 1M de token. O preço é de US$ 1,50 por milhão de tokens de entrada, US$ 4,50 por milhão de tokens de saída e US$ 0,075 para cache implícito, que é mais barato que Qwen3.8-Max. A comparação oficial mostra os primeiros lugares no DeepSWE v1.1, Agents' Last Exam v1.1, BioMysteryBench e um benchmark de agente jurídico, e perdas claras no Terminal-Bench 4.0 e ProgramBench. A API está ativa no QwenCloud com pagamento conforme o uso e faturamento do Token Plan, e o modelo não é de código aberto.
Por Cameron Voss e West Mao
O que foi lançado e onde você pode usá-lo
Alibaba lançou o Qwen4-Max em 16 de novembro de 2026. É o primeiro modelo da família Qwen 4: uma nova arquitetura esparsa de mistura de especialistas com 2,4 trilhões de parâmetros totais e 71 bilhões ativados por token, entrada nativa de imagens e uma janela de contexto de um milhão de tokens. O posicionamento oficial é um "companheiro de equipe de IA" para execução de longo prazo em trabalho real, em vez de um modelo de bate-papo.
A API está ativa no QwenCloud, onde pode ser chamada com cobrança conforme o uso ou por meio do Token Plan. Também há acesso direto no Qwen Studio, QwenWork e Qoder. O próprio Qwen4-Max não é de código aberto; Alibaba diz que modelos menores do Qwen 4 serão lançados posteriormente com pesos abertos da mesma geração.
Preço: mais barato que o modelo que substitui
Qwen4-Max custa US$ 1,50 por milhão de tokens de entrada e US$ 4,50 por milhão de tokens de saída. O cache implícito é de US$ 0,075 por milhão de tokens, uma redução de aproximadamente 70% no preço do cache; o valor equivale a 5% da tarifa de entrada sem cache. O Alibaba apresenta isso como um corte de preço em relação ao Qwen3.8-Max, não como um nível premium.
| Preço de tabela do Qwen4-Max | USD por 1 milhão de tokens |
|---|---|
| Entrada | US$ 1,50 |
| Saída | $4,50 |
| Cache implícito | $0,075 |
Preços do anúncio de 16 de novembro. Verifique a página de preços em tempo real do fornecedor antes de fazer o orçamento.
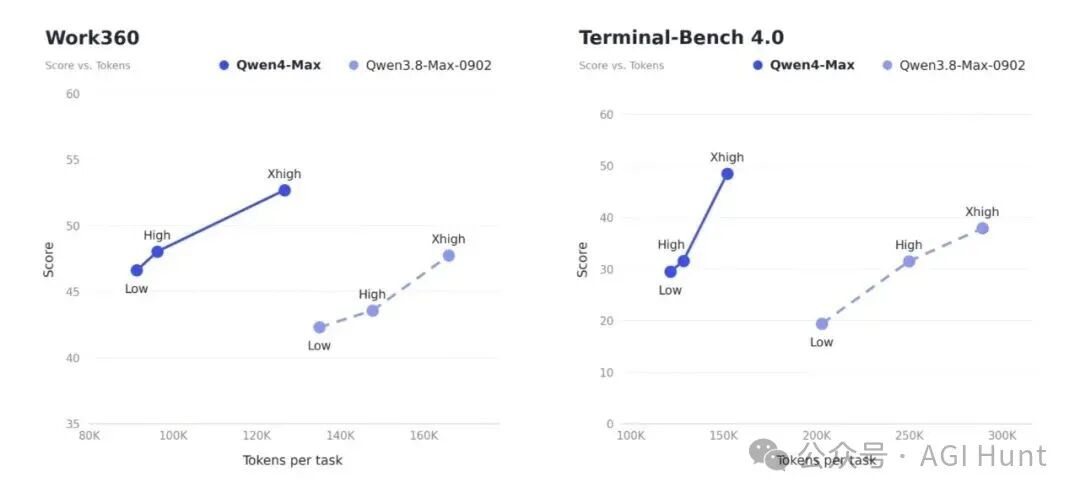
A quantidade de tokens consumidos importa tanto quanto a tarifa. No Work360, o fornecedor afirma que os níveis de raciocínio XHigh e High usam, respectivamente, cerca de 24% e 35% menos tokens que a geração anterior. No Terminal-Bench 4.0, as reduções seriam de 48% e 49%. Com as tarifas menores, o custo médio de uma tarefa do Work360 cairia de US$ 4,43 para US$ 1,67, uma redução de 62%.
Benchmarks: primeiro lugar em quatro testes, último lugar em dois
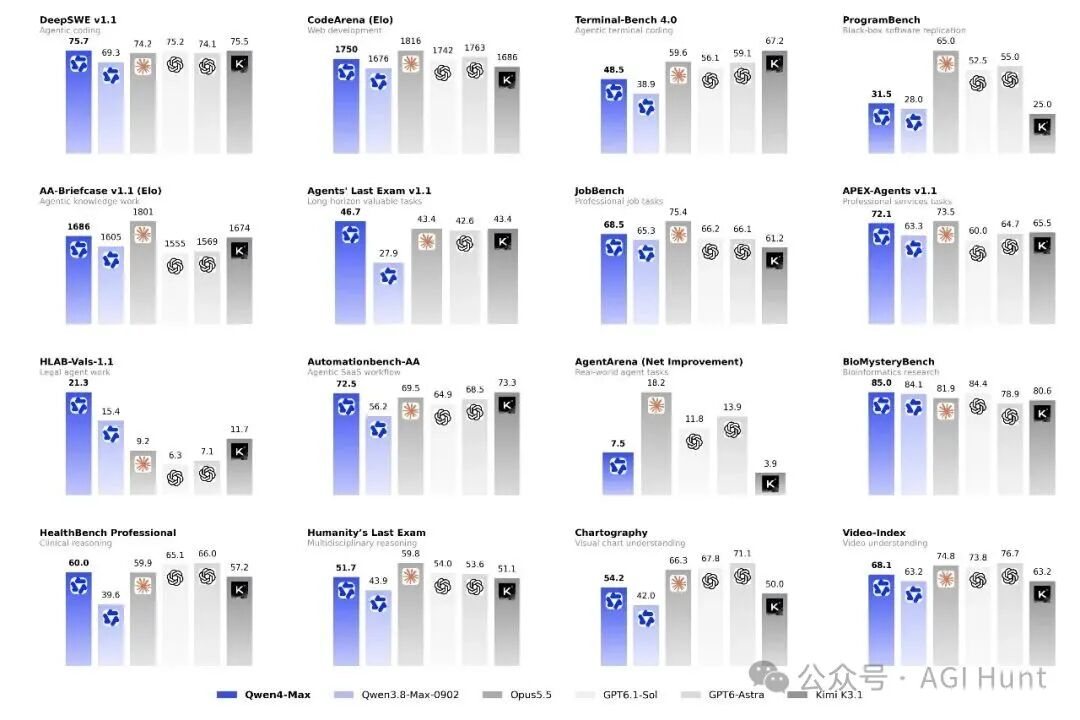
Alibaba comparou Qwen4-Max com Opus 5.5, GPT-6.1 Sol, GPT-6 Astra e Kimi K3.1. Ele fica em primeiro lugar no DeepSWE v1.1 com 75,7, Agents' Last Exam v1.1 com 46,7, BioMysteryBench com 85,0 e no benchmark de agente jurídico HLAB-Vals-1.1 com 21,3, que é mais que o dobro da pontuação do Opus 5.5 de 9,2.
A mesma tabela também mostra onde ele perde. No Terminal-Bench 4.0 ele pontua 48,5 contra Kimi K3.1 com 67,2. No ProgramBench, que pede a um modelo para reproduzir um software existente, ele pontua 31,5 contra 65,0 no Opus 5.5. A compreensão do gráfico e o AgentArena o colocam perto do final do grupo.
| Benchmark | Qwen4-Max | Comparação | Leitura |
|---|---|---|---|
| DeepSWE v1.1 | 75,7 | Lidera o conjunto | Tarefas de engenharia de software |
| Agents' Last Exam v1.1 | 46,7 | Lidera o conjunto | Trabalho do agente em longo horizonte |
| BioMysteryBench | 85,0 | Lidera o conjunto | Tarefas de pesquisa em biologia |
| HLAB-Vals-1.1 | 21,3 | Opus 5.5 com 9,2 | Trabalho de agente legal |
| Terminal-Bench 4.0 | 48,5 | Kimi K3.1 em 67,2 | Tarefas de terminal e shell |
| ProgramBench | 31,5 | Opus 5.5 a 65,0 | Reprodução de software existente |
Comparação relatada pelo fornecedor a partir do anúncio de lançamento. Nenhuma replicação independente foi publicada.
Work360: uma pontuação de 52,69 em um benchmark criado pelo Alibaba
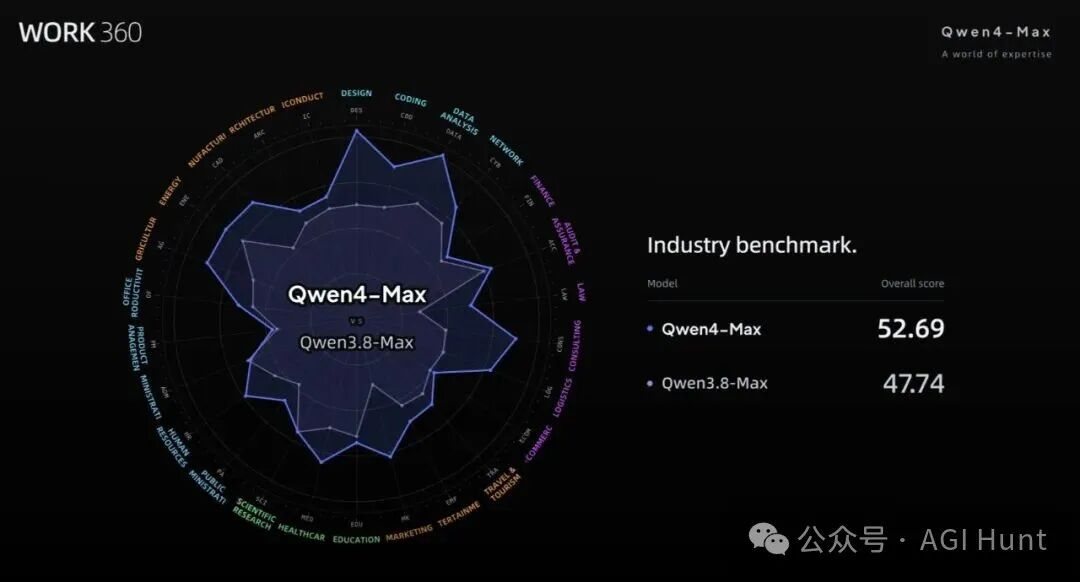
Para medir o trabalho em vez das respostas dos exames, a equipe Qwen construiu seu próprio benchmark de trabalho em camadas, o Work360, com 26 domínios de primeiro nível, 182 subdomínios e 721 áreas especializadas cobrindo design, codificação, finanças, direito, medicina, educação, logística e energia. Qwen4-Max obteve pontuação de 52,69, acima dos 47,74 da geração anterior, um ganho de cerca de 10%.
Um benchmark projetado pelo fornecedor é um contexto útil e uma evidência fraca ao mesmo tempo. É a única medição pública que abrange tantos tipos de trabalho e também é a referência que o fornecedor escolheu e pode revisar. Leia a classificação e execute suas próprias tarefas.
Escolhendo entre acesso oficial e um gateway? Leia o guia de assinatura do Qwen 4 para ver as rotas atuais, lista de modelos e etapas de configuração.
Arquitetura: atenção esparsa, conexões residuais com gates e um embedding maior
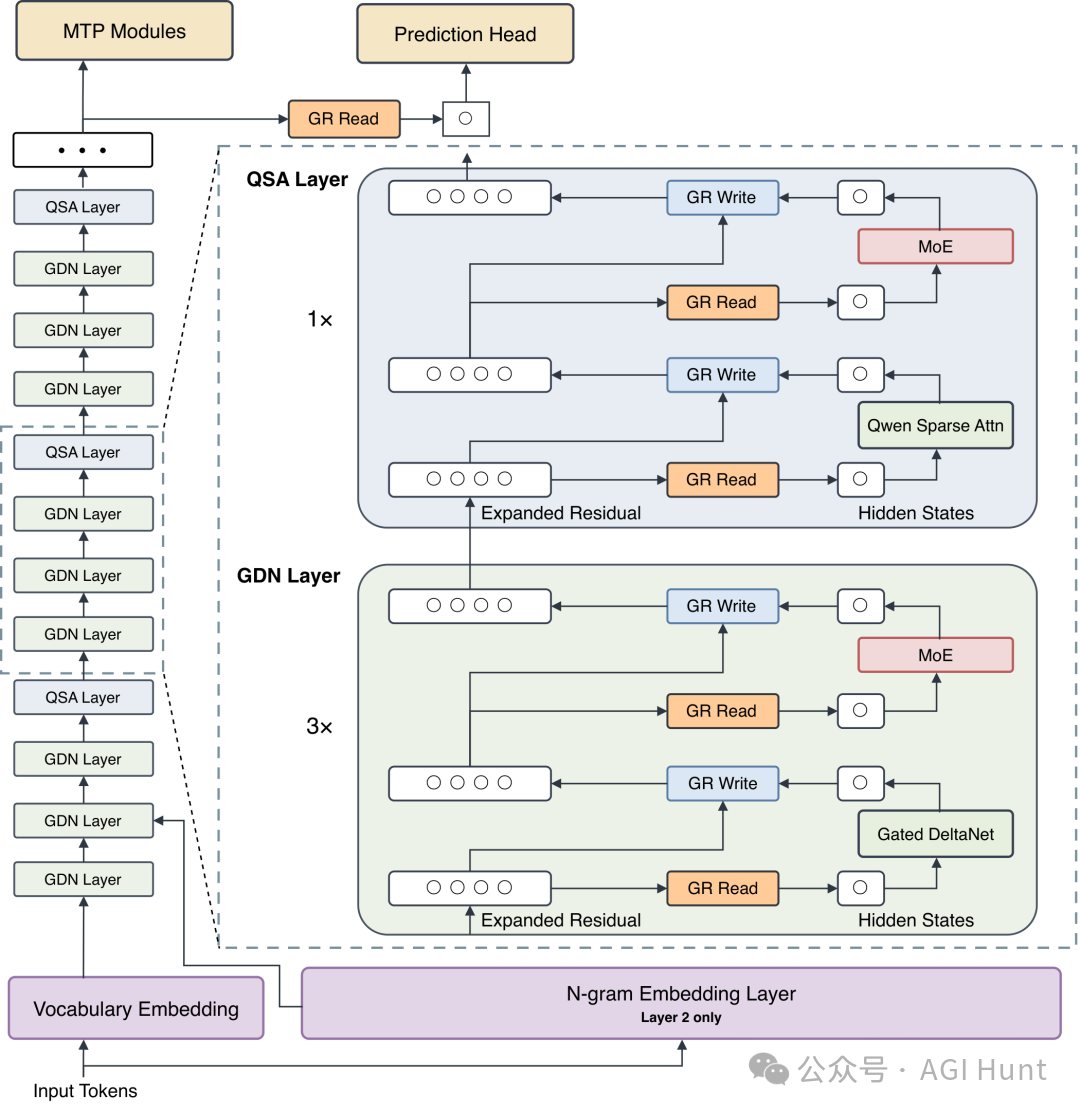
A arquitetura mudou em três pontos. O mecanismo de atenção combina Gated DeltaNet (GDN) com Qwen Sparse Attention (QSA), na proporção de três camadas GDN para uma QSA. O GDN comprime o histórico em um estado de tamanho fixo; o QSA usa um indexador leve para selecionar microblocos relevantes, reduzindo o custo de sequências longas. As conexões residuais passaram a ter quatro caminhos paralelos controlados por gates dinâmicos de leitura e escrita em cada camada, para melhorar a estabilidade do treinamento. A segunda camada adiciona um embedding de n-gramas com 328 bilhões de parâmetros extras e pouco custo computacional adicional.
Segundo o Alibaba, o treinamento do modelo com 2,4 trilhões de parâmetros não apresentou picos de perda. A empresa afirma ainda que o modelo-base usa 25% menos parâmetros ativos que o Qwen3.8-Max-Base e apresenta valores de bits por byte entre 5% e 13% menores, conforme o domínio. São resultados de treinamento; é preciso testar o desempenho nas suas próprias tarefas.
Seis demonstrações do setor no lançamento
As demonstrações fazem parte de um lançamento que um benchmark não pode substituir. O Alibaba executou o modelo em seis ambientes e relatou os resultados de cada um. Trate-os como demonstrações que o fornecedor escolheu e depois decida quais se parecem com seu trabalho.
3D e jogos. O modelo opera o Blender diretamente para modelagem, configuração de cena, materiais, iluminação e renderização, passando de um modelo branco bruto para uma tomada cinematográfica. Ele também cria jogos em Unity, Unreal Engine e Godot, executa-os para testar a si mesmo e ajusta o trabalho da câmera, a animação e o feedback do que vê. Os exemplos são um jogo xianxia do Unreal Engine, Yunguanxing, com uma luta de chefe contra um panda, e um jogo de corrida Unity 6 West Lake que foi empacotado como uma versão instalável do Android.
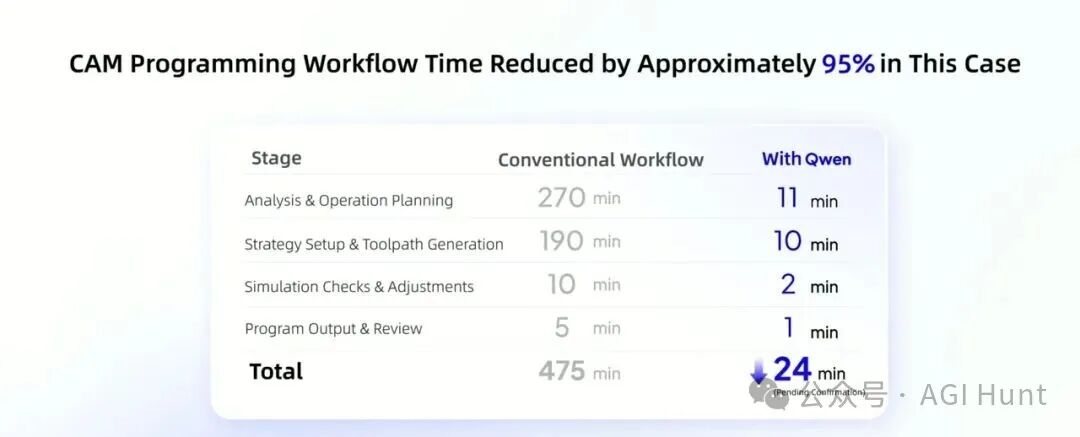
Fabricação. Na SANF e na Pacific Union, o modelo funcionava em ambientes de produção reais. Ela construiu uma linha de produção 3D a partir de um layout 2D e parâmetros de processo usando uma biblioteca de equipamentos existente, simulou tempos de ciclo e fez comissionamento virtual de CLP. No nível da peça, ela projetou conjuntos de portas e rodas de fricção, planejou sequências de usinagem, gerou caminhos de ferramenta e usou simulação para encontrar cortes excessivos e insuficientes antes da usinagem. O resultado relatado: o tempo de programação para uma única peça caiu de cerca de 475 minutos para 24 minutos, uma redução de 95%.
Descoberta científica. O modelo projetou e sintetizou uma nova molécula para fluido de arrefecimento para resfriamento de chips de alta potência de próxima geração. Conectado à plataforma de laboratório úmido e seco Mira da Deep Principle, ele funcionou de forma autônoma por 48 horas: pesquisou a rota técnica, construiu um espaço candidato de 2,7 milhões de moléculas, depois filtrou estruturas, previu propriedades, executou cálculos de primeiros princípios e análises de retrossíntese, e dirigiu um laboratório úmido automatizado para preparar reagentes, sintetizar, separar, purificar e testar. Após quatro rodadas de design, síntese, testes e aprendizado ativo, ele produziu uma amostra verificada fisicamente.
Projeto de medicamento. Na plataforma PharmMaster da Deep Principle, o modelo funcionou no alvo NLRP3 ligado à doença de Alzheimer. Fez 454 chamadas de ferramentas, completou 3.239 avaliações computacionais e projetou e refinou 24 moléculas candidatas; a escolha final tem uma afinidade de ligação prevista de cerca de 3,6 vezes a molécula de referência.
Finanças. Na pesquisa de ações, uma chamada utilizou 90 ferramentas MCP para coletar dados de ações A, Hong Kong, EUA, títulos, fundos e derivativos e, em seguida, entregou uma pasta de trabalho do Excel e uma apresentação de slides editável, com cada gráfico rastreável à pasta de trabalho e hiperlinks de células apontando para os dados de origem.
Jurídico. Na due diligence pré-IPO, 198 documentos originais chegaram com formatos e nomes de arquivo inconsistentes. O modelo os renomeou por conteúdo, arquivou-os em 14 pastas, verificou registros comerciais, propriedade intelectual, litígios e registros de crédito e produziu um relatório de 86 páginas com mais de 60.000 caracteres com uma citação da fonte para cada conclusão.
Medicina. Em uma conversa, ele leu seis dias de registros da UTI, incluindo dezenas de fichas de laboratório, mais de 10.000 caracteres de notas de progresso e 1.433 imagens brutas. Ela despachou subagentes para revisar centenas de cortes de tomografia computadorizada em paralelo, e suas quatro recomendações correspondiam aos pedidos reais do médico no mesmo dia, item por item.
| Domínio | Tarefa | Resultado reivindicado |
|---|---|---|
| 3D e jogos | Modelagem do Blender e renderização; Jogos Unreal Engine e Unity | Cenas finalizadas, uma versão jogável para Android |
| Fabricação | Linha de produção 3D, comissionamento virtual de CLP, percursos de ferramentas | De 475 para 24 minutos por peça |
| Materiais | Projeto de molécula para fluido de arrefecimento em uma plataforma de laboratório úmida e seca | Amostra sintetizada após quatro loops |
| Projeto de medicamentos | Candidatos NLRP3 no PharmMaster | 24 candidatos, afinidade prevista 3,6x |
| Finanças | 90 ferramentas MCP, Excel e entrega de deck | Gráficos rastreáveis até células de origem |
| Legal | Due diligence de 198 documentos | 86 páginas com fontes para cada conclusão |
| Médico | Seis dias de registros de UTI e revisão de tomografia computadorizada | Quatro recomendações correspondentes às prescrições médicas |
Todos os resultados são relatos do fornecedor sobre demonstrações selecionadas. Não são testes comparativos e não passaram por auditoria independente.
O agente 24 horas e o plugin Live Delivery
Qwen4-Max é lançado para agentes de longa duração. O lançamento adiciona Live Delivery: em vez de esperar até que uma tarefa longa termine, o agente envia uma primeira versão utilizável antecipadamente e depois itera, para que um usuário possa intervir e corrigir o curso. O complemento Qwen-Live-Delivery-Plugin é de código aberto.
O Alibaba Cloud também relata o uso do modelo internamente para ajustar seu próprio agendamento de computação: o custo da chamada do modelo de anotação caiu 10,42% em média, e o reescalonamento da CPU offline foi resolvido mais de 14,61 vezes mais rápido. Números internos desse tipo são difíceis de verificar externamente e medem as cargas de trabalho do próprio fornecedor.
Declarações de segurança
O treinamento de código adicionou verificações de segurança junto com as funcionais. No Last Secure Code Bench, a taxa de aprovação em nível de função para correção e segurança juntas aumentou de 22,0% para 31,8%, e a parcela de aprovação em nível de função, arquivo e repositório aumentou de 8% para 14,7%, quase dobrando. Alibaba também afirma que os dados de treinamento que fortalecem a capacidade de ataque foram removidos.
O que este lançamento não resolve
Quatro pontos continuam em aberto. A tabela de benchmarks foi produzida pelo fornecedor, e não há reprodução independente das diferenças no Terminal-Bench ou no ProgramBench. As demonstrações foram selecionadas e não informam taxas de falha. A economia de 24% a 49% em tokens depende da tarefa e do nível de raciocínio, portanto não se aplica automaticamente a toda conta. Por fim, o modelo é fechado; a empresa promete modelos menores com pesos abertos.