Qwen4-Maxが登場:総パラメータ2.4兆、入力100万トークンあたり1.50ドル、6分野のデモ
要点 アリババは2026年11月16日、Qwen 4シリーズ初のモデル「Qwen4-Max」を公開した。総パラメータ数は2.4兆で、各トークンの処理時に710億を活性化するスパースMoEモデルだ。画像入力にネイティブ対応し、コンテキスト長は100万トークン。発表時の料金は100万トークンあたり入力1.50ドル、出力4.50ドル、暗黙キャッシュ0.075ドルで、Qwen3.8-Maxより安い。提供元の比較ではDeepSWE v1.1、Agents’ Last Exam v1.1、BioMysteryBench、法務エージェントのベンチマークで首位となる一方、Terminal-Bench 4.0とProgramBenchでは後れを取っている。APIはQwenCloudで従量課金またはToken Planを通じて利用でき、モデルはオープンソースではない。
投稿者: Cameron Voss と West Mao
発表内容と利用できる場所
アリババは2026年11月16日、Qwen 4シリーズ初のモデル「Qwen4-Max」を公開した。スパースなMixture of Experts(MoE)アーキテクチャを採用し、総パラメータ数は2.4兆、各トークンの処理時に710億を活性化する。画像をネイティブに入力でき、コンテキスト長は100万トークン。アリババは、長時間にわたる実務の遂行を支援する「AIチームメイト」と位置づけている。
APIはQwenCloudで従量課金またはToken Planを通じて利用できる。Qwen Studio、QwenWork、Qoderからも直接利用できる。Qwen4-Max自体はオープンソースではない。アリババは、同世代の小型Qwen 4モデルを後日オープンウェイトで公開するとしている。
価格:前モデルより安く
料金は100万トークンあたり入力1.50ドル、出力4.50ドル。暗黙キャッシュは0.075ドルで、従来のキャッシュ料金から約70%下がり、新規入力料金の5%に相当する。アリババはQwen3.8-Maxからの値下げとして紹介している。
| Qwen4-Maxの発表時料金 | 100 万トークンあたり米ドル |
|---|---|
| 入力 | $1.50 |
| 出力 | $4.50 |
| 暗黙的キャッシュ | $0.075 |
11月16日の発表時点の価格。予算を立てる際は、提供元の最新料金を確認しよう。
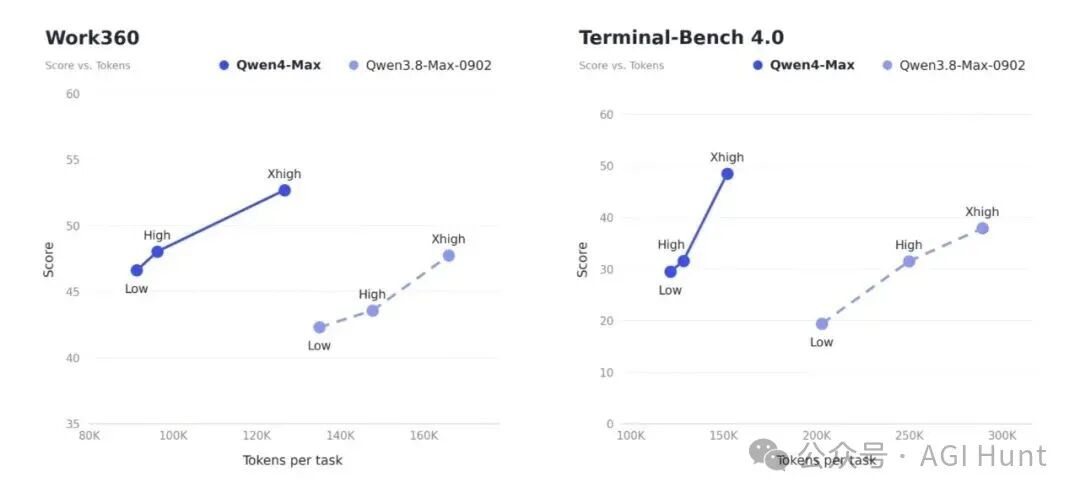
単価に加え、タスクに必要なトークン数もコストを左右する。提供元によると、Work360では推論レベルXHighとHighで前世代より使用トークン数がそれぞれ約24%、35%減り、Terminal-Bench 4.0では約48%、49%減った。単価の引き下げと合わせて、Work360の1タスクあたり平均コストは4.43ドルから1.67ドルへ、62%低下したという。
ベンチマーク:4項目で首位、2項目で最下位
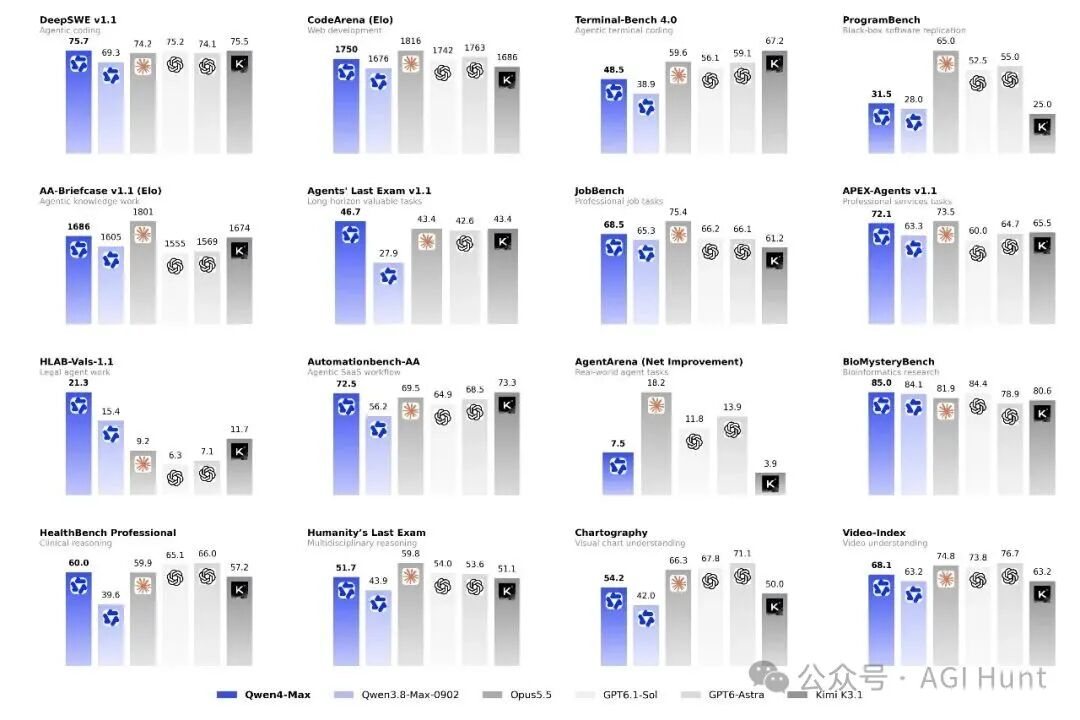
アリババはQwen4-MaxをOpus 5.5、GPT-6.1 Sol、GPT-6 Astra、Kimi K3.1と比較した。Qwen4-MaxはDeepSWE v1.1で75.7、Agents’ Last Exam v1.1で46.7、BioMysteryBenchで85.0、法務エージェントのHLAB-Vals-1.1で21.3を記録し、この比較ではいずれも首位だった。HLAB-Vals-1.1のスコアはOpus 5.5の9.2の2倍以上となる。
一方、Terminal-Bench 4.0では48.5と、Kimi K3.1の67.2を下回った。既存ソフトウェアの再現を求めるProgramBenchでも31.5と、Opus 5.5の65.0に及ばない。チャートの理解とAgentArenaでも、比較対象の中では下位に位置する。
| ベンチマーク | Qwen4-Max | 比較 | 評価する内容 |
|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 比較対象の中で首位 | ソフトウェア エンジニアリング タスク |
| Agents' Last Exam v1.1 | 46.7 | 比較対象の中で首位 | 長期的なエージェントの仕事 |
| BioMysteryBench | 85.0 | 比較対象の中で首位 | 生物学研究タスク |
| HLAB-Vals-1.1 | 21.3 | Opus 5.5:9.2 | 法務エージェントのタスク |
| Terminal-Bench 4.0 | 48.5 | Kimi K3.1:67.2 | ターミナルとシェルのタスク |
| ProgramBench | 31.5 | Opus 5.5:65.0 | 既存のソフトウェアを再現 |
発表時に提供元が報告した比較。独立した再現結果は公表されていない。
Work360:アリババ独自のベンチマークで52.69点
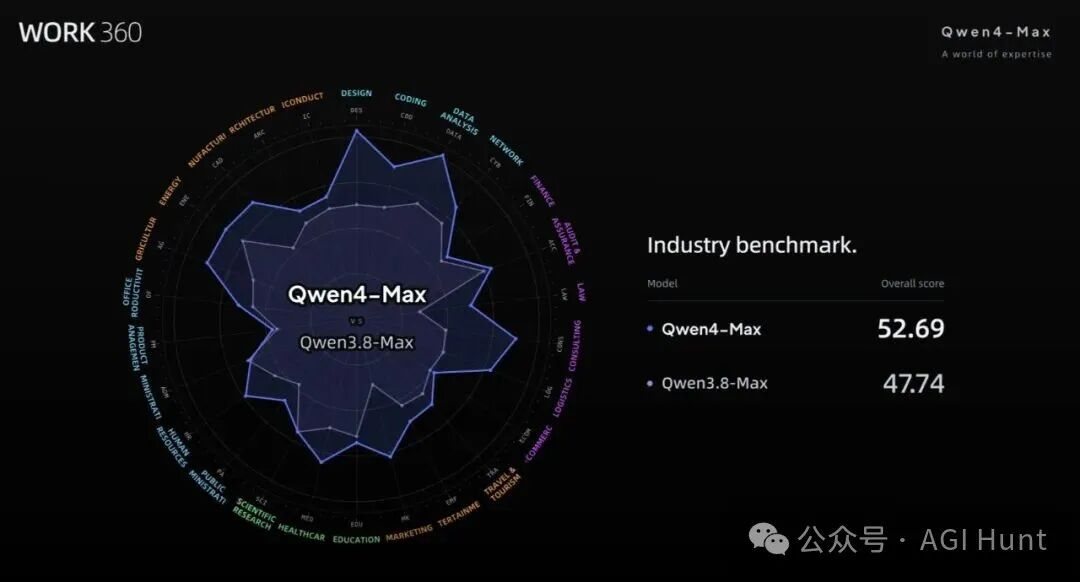
Qwenチームは、試験問題への回答だけでなく実務を測るため、独自の階層型ベンチマークWork360を作成した。設計、コーディング、金融、法務、医療、教育、物流、エネルギーなどを含む26の大分類、182の小分類、721の専門領域を対象とする。Qwen4-Maxは52.69点で、前世代の47.74点から約10%向上した。
提供元が設計したベンチマークは参考になる一方、それだけで性能を判断するには根拠が弱い。これほど多くの職種を対象とする公開指標は他にないが、評価基準を選び、変更できるのも提供元だ。順位を確認したうえで、自分の業務でも試したい。
公式アクセスとゲートウェイのどちらを選択しますか? 現在のルート、モデル リスト、セットアップ手順については、Qwen 4 サブスクリプション ガイドをお読みください。
アーキテクチャ:スパースアテンション、ゲート付き残差接続、拡張された埋め込み
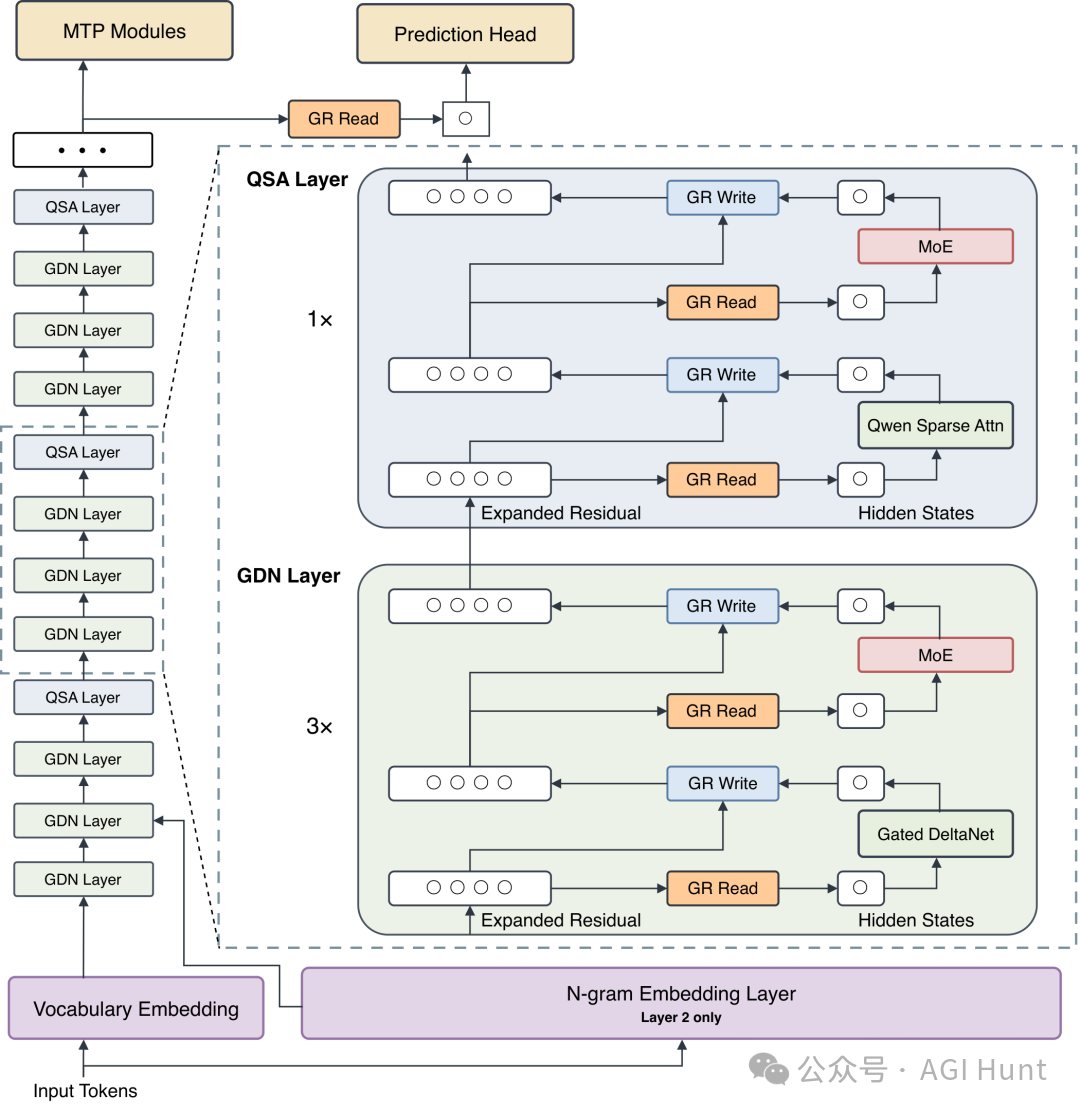
アーキテクチャには3つの変更がある。まず、アテンションにはGated DeltaNet(GDN)とQwen Sparse Attention(QSA)を、GDNの3層に対してQSAの1層を組み合わせる。GDNは履歴を固定サイズの状態に圧縮し、QSAは軽量なインデクサーで関連するマイクロブロックを選ぶことで、長い系列の計算コストを抑える。残差接続は4本の並列ゲート経路となり、各層の読み書きを動的なゲートで制御して学習の安定化を図る。さらに第2層に、追加の計算量をほとんど増やさずに3,280億パラメータを加えるN-gram埋め込みを導入した。
アリババによると、2.4兆パラメータの学習中に損失値のスパイクは発生しなかった。また、ベースモデルの活性パラメータ数はQwen3.8-Max-Baseより25%少なく、各領域のbits per byteは5〜13%低かったという。いずれも学習に関する提供元の報告であり、個々の用途での性能は別途検証が必要だ。
発表時に紹介された6分野のデモ
アリババはさまざまな分野でモデルを試し、その結果を報告した。ベンチマークでは分からない作業の流れを見ることができるが、いずれも提供元が選んだデモである。自分の業務に近いものがあるかを確認したい。
3D・ゲーム。モデルはBlenderを直接操作してモデリング、シーン構成、マテリアル、照明、レンダリングを行い、白いラフモデルから映画的な映像を作る。Unity、Unreal Engine、Godotでもゲームを作成し、実行して自らテストしたうえで、画面を見ながらカメラワーク、アニメーション、攻撃のヒット演出を調整する。例として、パンダとのボス戦があるUnreal Engine製の仙侠ゲーム「Yunguanxing」と、Android向けにビルドされたUnity 6製の西湖レースゲームが示された。
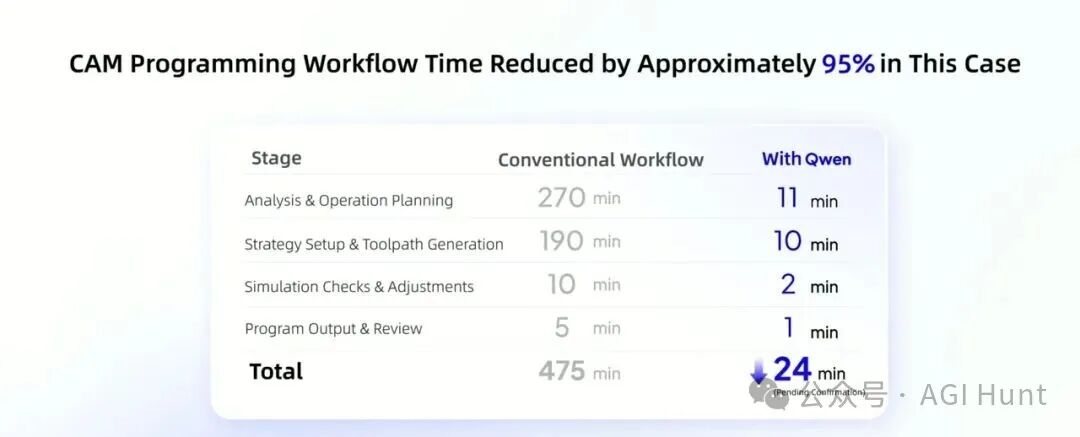
製造。SANFとPacific Unionの実際の生産環境では、既存の設備ライブラリを使い、2Dレイアウトと工程パラメータから3D生産ラインを構築した。サイクルタイムのシミュレーションとPLCの仮想試運転も実施。部品単位ではドアの組立部品や摩擦ホイールを設計し、加工順序とツールパスを作成したうえで、シミュレーションにより削り過ぎや削り残しを確認した。報告によると、1部品のプログラミング時間は約475分から24分へ、95%短縮した。
科学研究。次世代の高出力チップを冷却する新しい冷却剤分子を設計・合成した。Deep Principleの湿式・乾式実験プラットフォームMiraにつなぎ、48時間自律稼働したという。技術経路を調査し、270万分子の候補から構造を絞り込み、物性予測、第一原理計算、逆合成解析を実施。自動化された湿式実験室に試薬の準備、合成、分離、精製、試験を指示した。設計、合成、試験、能動学習を4回繰り返し、実物の試料を得て検証した。
創薬。Deep PrincipleのPharmMaster上で、アルツハイマー病と関連するNLRP3標的に取り組んだ。ツールを454回呼び出し、3,239件の計算評価を行い、24の候補分子を設計・改良。最終候補の予測結合親和性は、参照分子の約3.6倍だったという。
金融。株式調査のデモでは、1回の呼び出しで90のMCPツールを使い、中国A株、香港・米国株、債券、ファンド、デリバティブのデータを収集した。成果物はExcelブックと編集可能なスライドで、各グラフはブック内のセルに、セルのリンクは元データにたどれるという。
法務。IPO前のデューデリジェンスでは、形式やファイル名が統一されていない198件の資料を処理した。内容に応じて名前を変更し、14のフォルダに分類。企業登記、知的財産、訴訟、信用情報を照合し、各結論に出典を付けた6万文字超、86ページの報告書を作成した。
医療。1回の対話で、6日分のICU記録を読み込んだ。資料には多数の検査結果、1万文字以上の経過記録、1,433枚の生画像が含まれる。サブエージェントが数百枚のCT画像を並行して確認し、4つの提案は同日の医師の実際の指示と項目ごとに一致したという。
| 分野 | タスク | 提供元が報告した結果 |
|---|---|---|
| 3D とゲーム | Blender モデリングとレンダリング; Unreal Engine と Unity ゲーム | 完成シーン、プレイアブル Android ビルド |
| 製造 | 3D 生産ライン、PLC 仮想コミッショニング、ツールパス | 1部品あたり475分から24分に短縮 |
| 材料 | 湿式・乾式実験プラットフォームでの冷却剤分子設計 | 4回の反復後に合成された試料 |
| 創薬 | PharmMaster での NLRP3 候補 | 24 候補、予測親和性 3.6 倍 |
| 金融 | 90のMCPツールを使用し、Excelとスライドを作成 | ソースセルまで追跡可能なグラフ |
| 法務 | 198 の文書デューデリジェンス | 86ページ、各結論に出典を付記 |
| 医療 | 6 日間の ICU 記録と CT レビュー | 医師の指示と一致した4つの提案 |
これらはすべて提供元が報告したデモの結果である。条件をそろえた比較試験ではなく、独立した監査も受けていない。
24 時間エージェントと Live Delivery プラグイン
Qwen4-Maxは長時間稼働するエージェントを想定している。新しいLive Deliveryでは、タスクの完了を待たずに使える初版を早期に届け、その後改善を重ねる。ユーザーは途中で介入し、方向を修正できる。関連するQwen-Live-Delivery-Pluginはオープンソースだ。
Alibaba Cloudは、社内の計算資源スケジューリングにもこのモデルを使用したと報告している。アノテーション用モデルの呼び出しコストは平均10.42%減り、オフラインのCPU再スケジューリングは14.61倍以上高速に解けたという。社内の数値を外部から検証することは難しく、対象も同社自身のワークロードに限られる。
安全性に関する主張
コードの学習では、機能面に加えてセキュリティの検査も導入した。Last Secure Code Benchでは、関数レベルで正確性と安全性の両方を満たした割合が22.0%から31.8%に上昇。関数・ファイル・リポジトリの各レベルで合格した割合も8%から14.7%へと、ほぼ倍増した。アリババは、攻撃能力を高める学習データも除去したとしている。
今回の発表だけでは分からないこと
未解決の点は4つある。ベンチマークは提供元によるもので、Terminal-BenchやProgramBenchの結果は独立して再現されていない。デモは選ばれた事例であり、失敗率は示されていない。トークン削減率の24〜49%は推論レベルとタスクに依存するため、すべての利用で同じ節約が得られるわけではない。また、Qwen4-Maxのウェイトは公開されていない。小型モデルのオープンウェイト公開は予告されている。