Avanço: Kimi K3.1 Pro entra no top 4 mundial e supera GPT‑6 e Gemini 4
Por Cameron Voss
Atualizado em
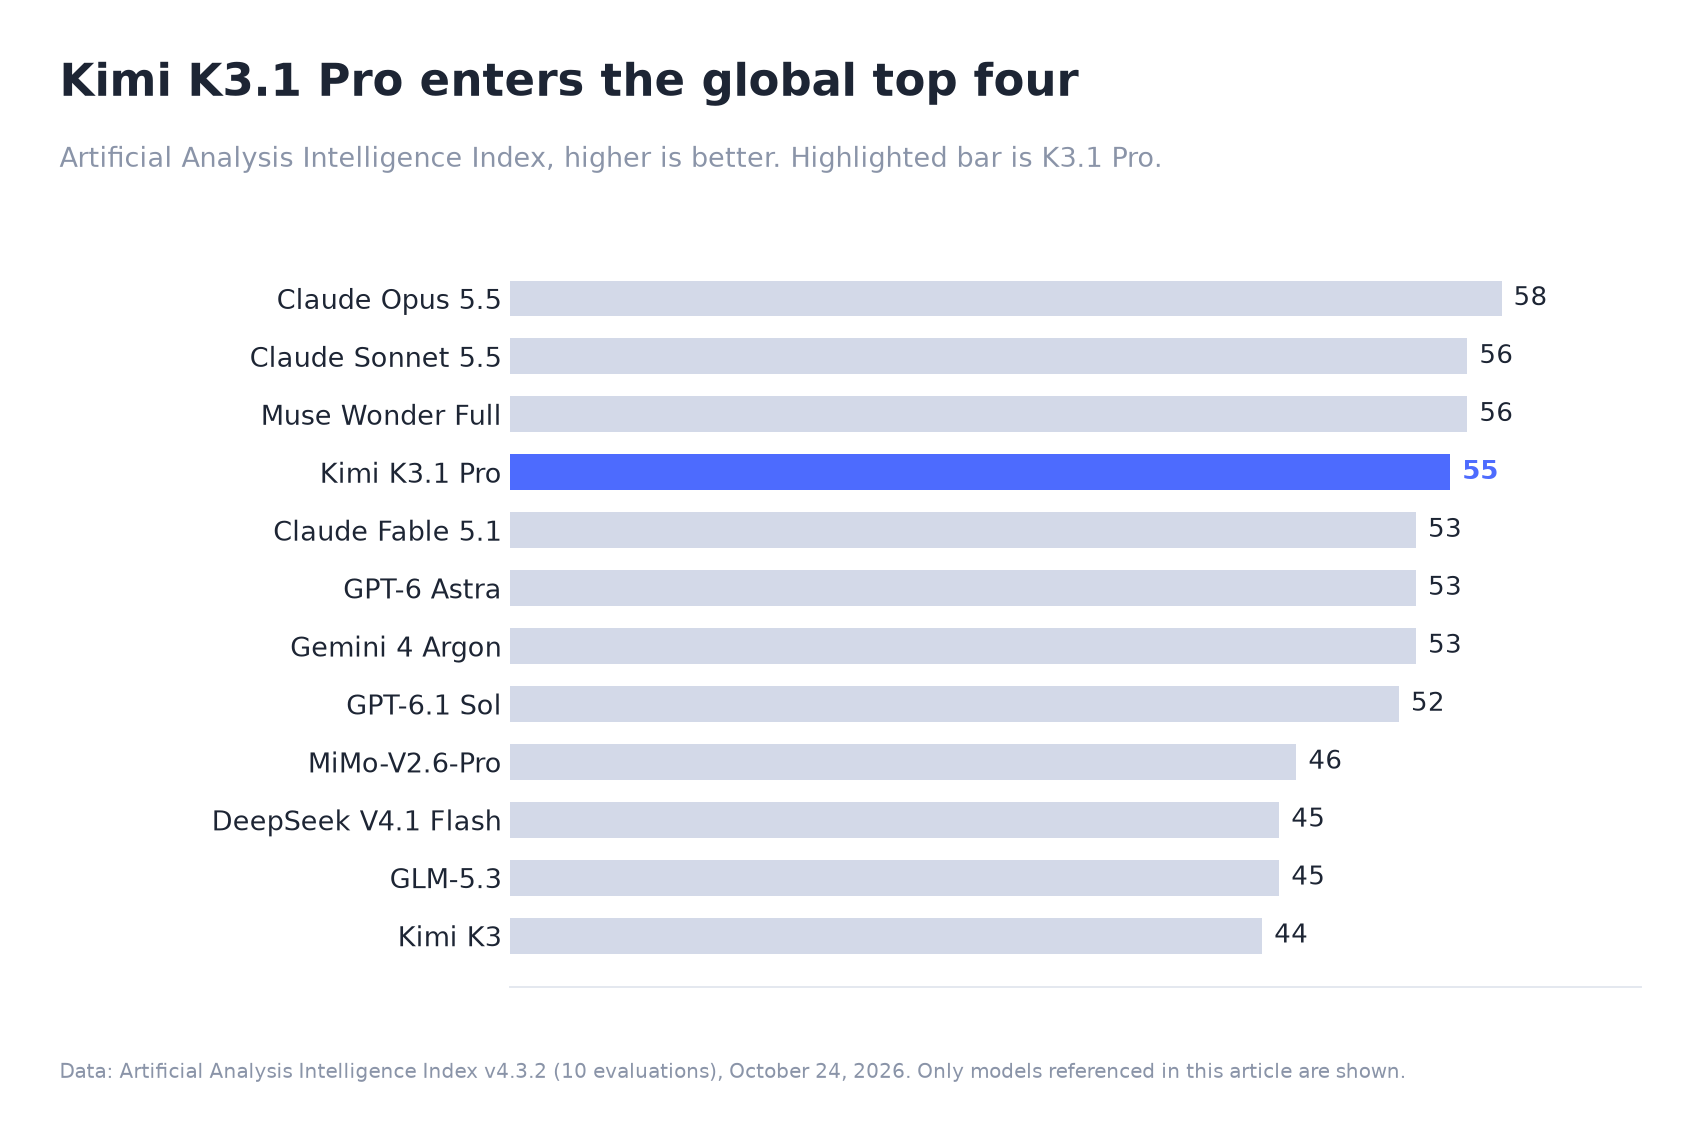
ResumoO Kimi K3.1 Pro marca 55 pontos no Intelligence Index da Artificial Analysis e fica em quarto lugar no mundo, atrás de Claude Opus 5.5, Claude Sonnet 5.5 e Muse Wonder Full, da Meta, e dois pontos à frente de GPT-6 Astra e Gemini 4 Argon. Ele tem os mesmos 2,8 trilhões de parâmetros totais e 104 bilhões de parâmetros ativos do K3; o ganho de 11 pontos veio do pós-treinamento. Lidera a avaliação independente do Terminal-Bench 4.0 com 67,2% e custa cerca de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, na mesma faixa do Claude Sonnet 5.5. Os pesos foram prometidos para antes de 4 de novembro. Na votação humana, ele ainda fica em oitavo.
Nesta página
O K3 chegou em 16 de julho com 44 pontos. Três meses depois, a nova versão marca 55, sem que a Moonshot tenha acrescentado um único parâmetro. Esse é o ponto mais interessante: um modelo mais barato de servir, acompanhado de uma redução de preço.
A manchete é correta, mas tem um alcance limitado. O K3.1 Pro supera o GPT-6 Astra e o Gemini 4 Argon por dois pontos no índice. Ele não supera o Claude na mesma faixa de preço, e quem avalia os resultados sem saber qual modelo os produziu se mostra menos impressionado do que a bateria automatizada de testes.
O que já dá para usar?
Quase tudo, menos os pesos do modelo. O K3.1 Pro já está disponível no Kimi.ai, no aplicativo Kimi, no Kimi Work, no Kimi Code e na API do Kimi. O identificador do modelo é kimi-k3.1-pro. A versão Highspeed oferece a mesma capacidade, com velocidade de geração de saída duas a três vezes maior, pelo dobro do preço. O acesso empresarial vem desativado por padrão.
A Moonshot diz que os pesos serão disponibilizados antes de 4 de novembro, mas ainda não informou a licença. Tanto a Artificial Analysis quanto a Arena esperam que ele se torne o modelo de pesos abertos mais forte quando os pesos forem publicados.
Como ganhou 11 pontos sem aumentar o número de parâmetros?
Com pós-treinamento. O K3.1 Pro usa a base do K3, com 2,8 trilhões de parâmetros no total e 104 bilhões ativos por token, e acrescenta uma grande quantidade de computação de pós-treinamento em centenas de domínios. A Moonshot também reformulou a infraestrutura de aprendizado por reforço, os ambientes isolados de execução e o agendamento para sustentar esse processo.
O dado de eficiência importa mais do que a posição no ranking. O MiMo-V2.6-Pro marca 46 pontos com 1,02 trilhão de parâmetros, e o GLM-5.3 marca 45 com 753 bilhões. O K3.1 Pro obtém cerca de dez pontos a mais com um modelo maior, mas que ativa apenas uma parte dos parâmetros a cada token.
Em quais tarefas ele é realmente melhor?
Na execução de tarefas por agentes. Os ganhos se concentram em tarefas nas quais o modelo atua em um ambiente, em vez de apenas responder a uma pergunta.
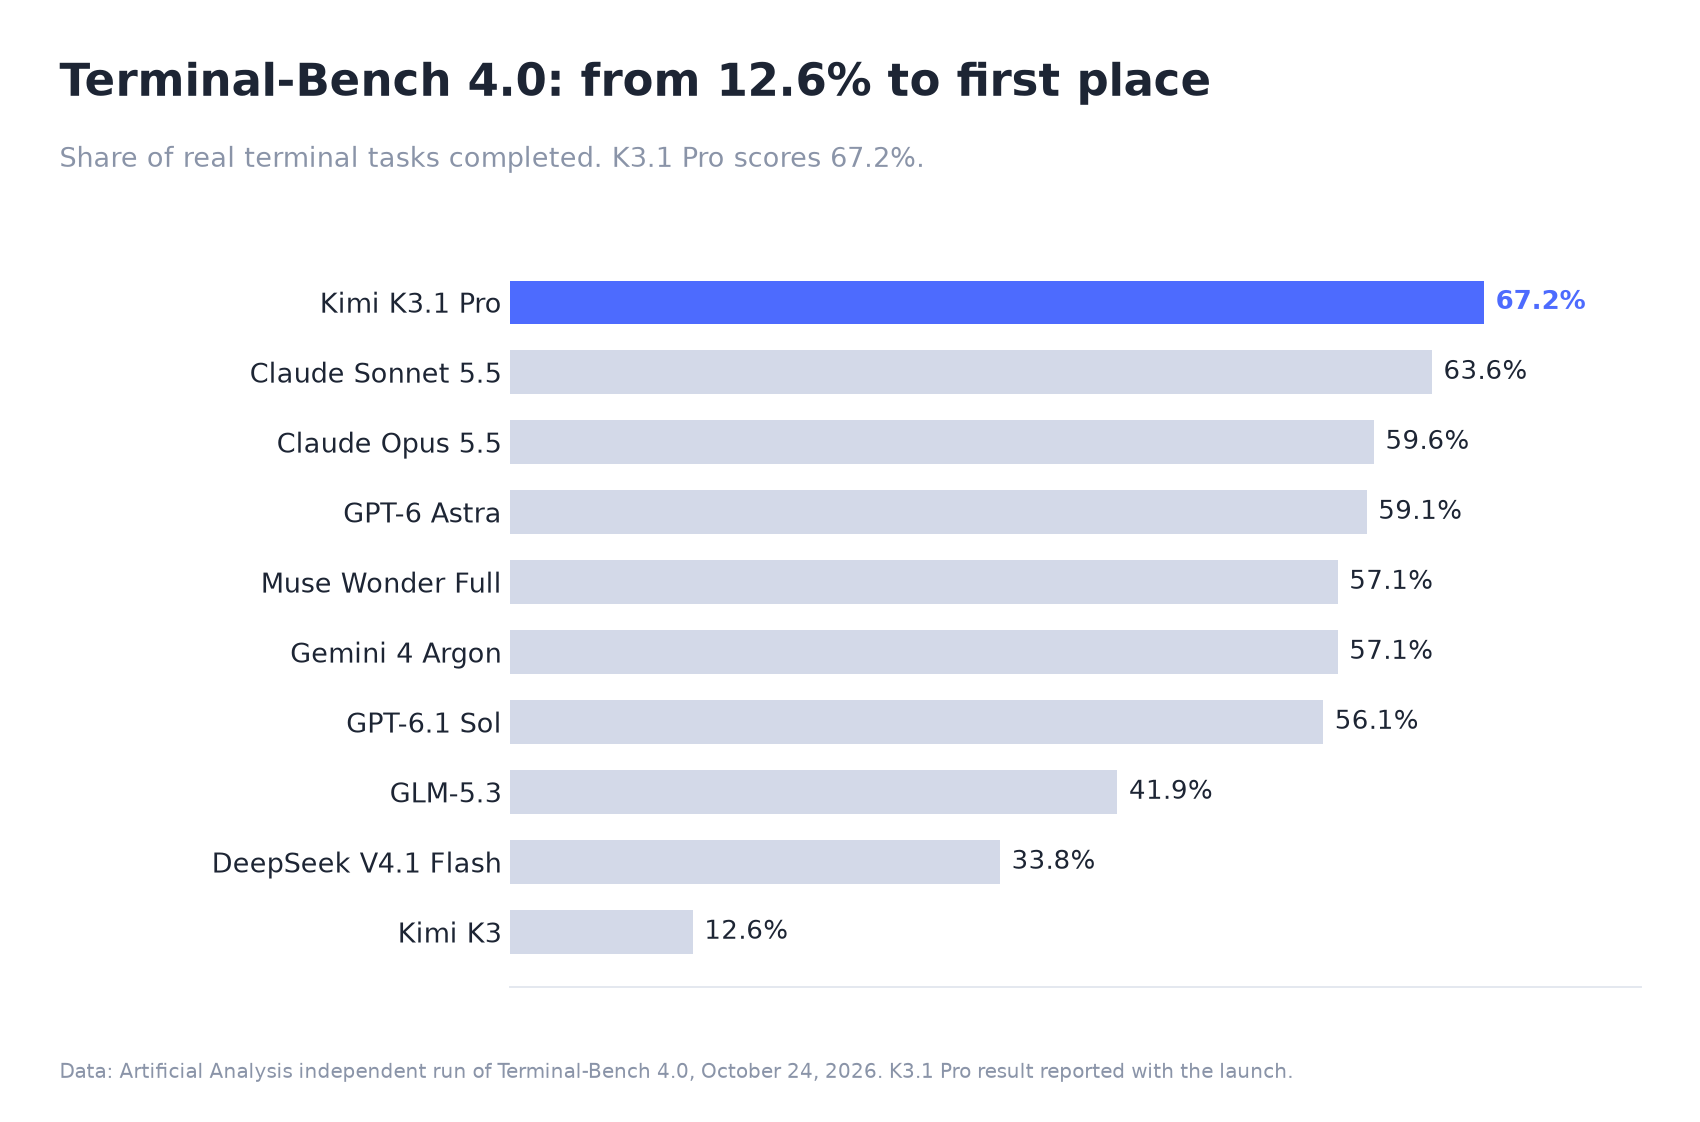
O Terminal-Bench 4.0 é a evidência mais forte porque a Artificial Analysis o executou de forma independente. O K3.1 Pro ficou em primeiro lugar, com 67,2%, contra 63,6% do Claude Sonnet 5.5 e 12,6% do K3. No GDPval-AA, ficou em terceiro, 312 pontos acima do K3, e no AutomationBench passou de 58% para 73%.
| Teste | K3.1 Pro | Concorrente mais próximo | Responsável pelo teste |
|---|---|---|---|
| Terminal-Bench 4.0 | 67,2% | Sonnet 5.5, 63,6% | Artificial Analysis |
| GDPval-AA | 3º, +312 em relação ao K3 | Opus 5.5, Muse Wonder Full | Artificial Analysis |
| AutomationBench | 73% | Não divulgado | Artificial Analysis |
| SWE Marathon | 51,7 | Opus 5.5, com pontuação inferior | Moonshot |
| Terminal-Bench Science | 38,1 | GPT-6 Astra, 68,1 | Moonshot |
As demonstrações da Moonshot seguem o mesmo foco: uma cena jogável no Unreal Engine 5.8, uma página de navegador com um braço robótico de 2.317 peças, um turbofan no FreeCAD com 2.100 sólidos e um humano simulado que passou por 167 tarefas e 420 autoavaliações antes de caminhar por 11,2 segundos. No BenchCAD, que pede código CAD capaz de reconstruir uma peça a partir de imagens renderizadas, o K3.1 Pro fica um pouco atrás do Opus 5.5 e do GPT-6 Astra quando usa ferramentas e empata com o Opus 5.5 sem elas. É um resultado sólido, mas não de liderança.
Por que ele fica em oitavo na votação humana?
Porque a Arena WebDev usa votos de preferência em testes cegos, e não uma bateria fixa de testes. Dois modelos criam a mesma página, e uma pessoa escolhe o melhor resultado sem ver o nome de cada modelo.
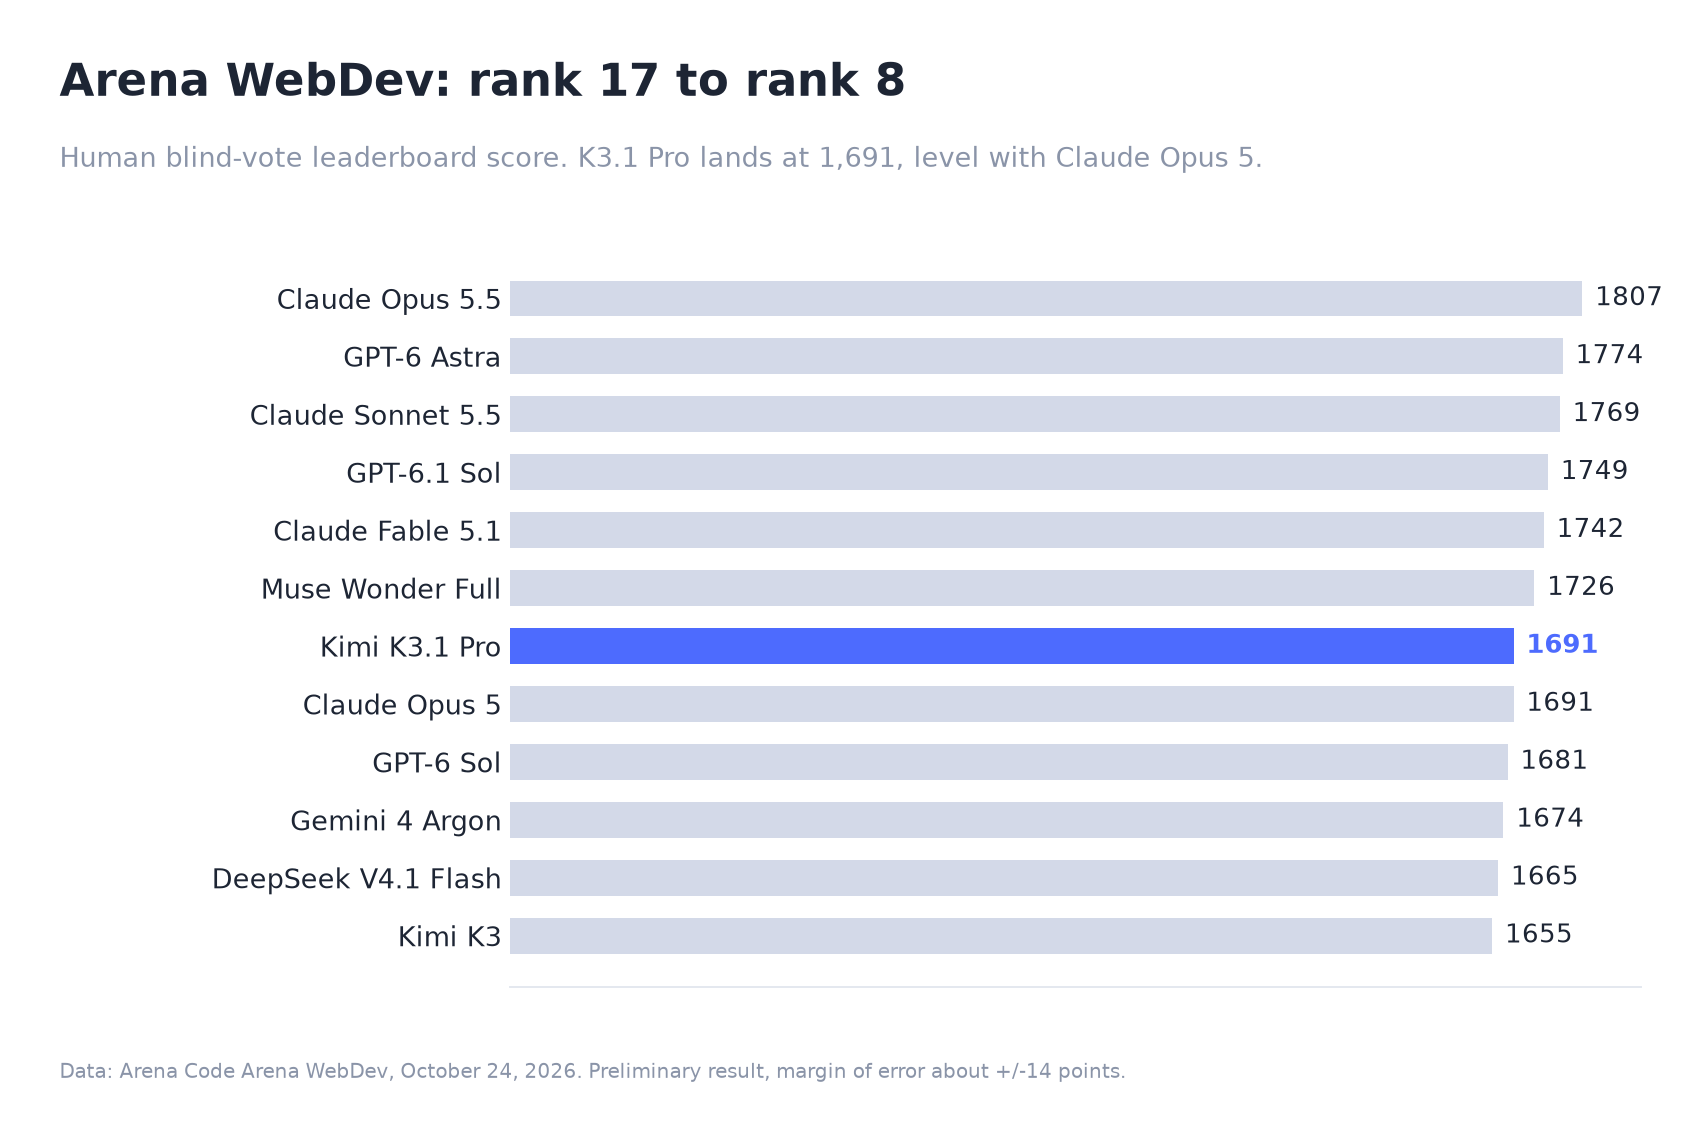
O K3.1 Pro marcou 1.691 pontos, subiu do 17º lugar e empatou com o Claude Opus 5. O Claude Opus 5.5 lidera com 1.807, seguido pelo GPT-6 Astra com 1.774 e pelo Sonnet 5.5 com 1.769. Entre os modelos chineses, ele agora está em primeiro, e deve liderar os modelos de pesos abertos quando os pesos forem publicados. Na votação humana, a distância para os líderes é simplesmente maior do que no índice.
Quanto custa?
O preço de tabela é de CNY 13 por milhão de tokens de entrada e CNY 68 por milhão de tokens de saída, cerca de US$ 2 e US$ 10. Isso representa uma redução de aproximadamente um terço em relação ao K3. O Highspeed custa o dobro.
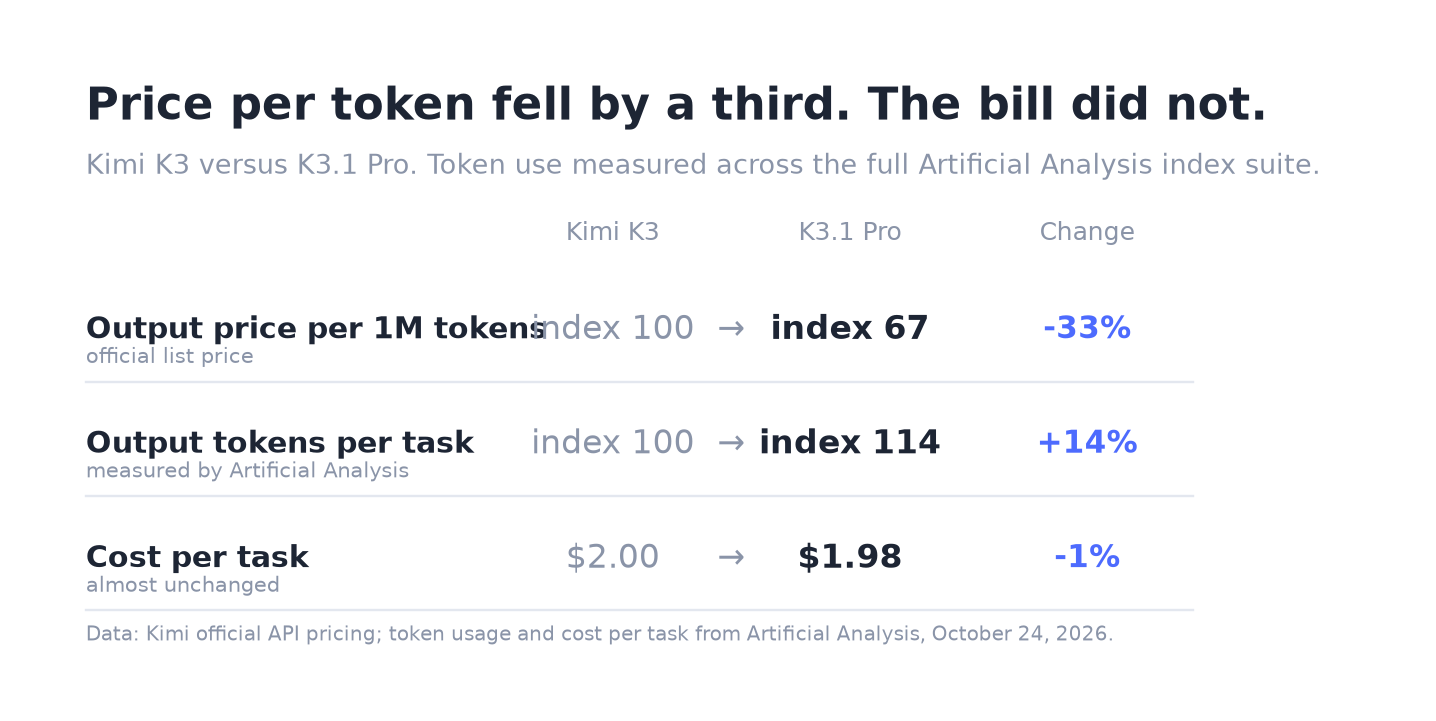
O desconto tem uma contrapartida. Na bateria completa da Artificial Analysis, o K3.1 Pro usou 14% mais tokens por tarefa. Os dois efeitos quase se anulam: US$ 1,98 por tarefa, contra US$ 2,00.
| Modelo | Entrada / saída por milhão de tokens | Pontuação AA |
|---|---|---|
| Claude Opus 5.5 | US$ 4 / US$ 20 | 58 |
| Claude Sonnet 5.5 | US$ 2 / US$ 10 | 56 |
| Kimi K3.1 Pro | US$ 2 / US$ 10 | 55 |
| GPT-6 Astra | US$ 10 / US$ 50 | 53 |
| DeepSeek V4.1 Flash | US$ 0,30 / US$ 1,20 | 45 |
Preços oficiais de tabela em 24 de outubro de 2026. As pontuações usam o nível máximo de raciocínio de cada modelo.
O preço é o mesmo de Sonnet 5.5, Gemini 4 Argon e GPT-6.1 Sol. É metade do preço do Opus 5.5 e um quinto do GPT-6 Astra. DeepSeek V4.1 Flash e GLM-5.3 custam bem menos, mas ficam cerca de dez pontos atrás no índice. A Arena registra um custo mediano de US$ 1,23 por tarefa, 29% abaixo do K3.
Como fica o custo-benefício?
Ao comparar pontuação e preço de tabela, o K3.1 Pro deixa em desvantagem os modelos que custam mais e não pontuam melhor: o GPT-6 Astra, com preço cerca de cinco vezes maior, além do Gemini 4 Argon e do GPT-6.1 Sol, que custam o mesmo.
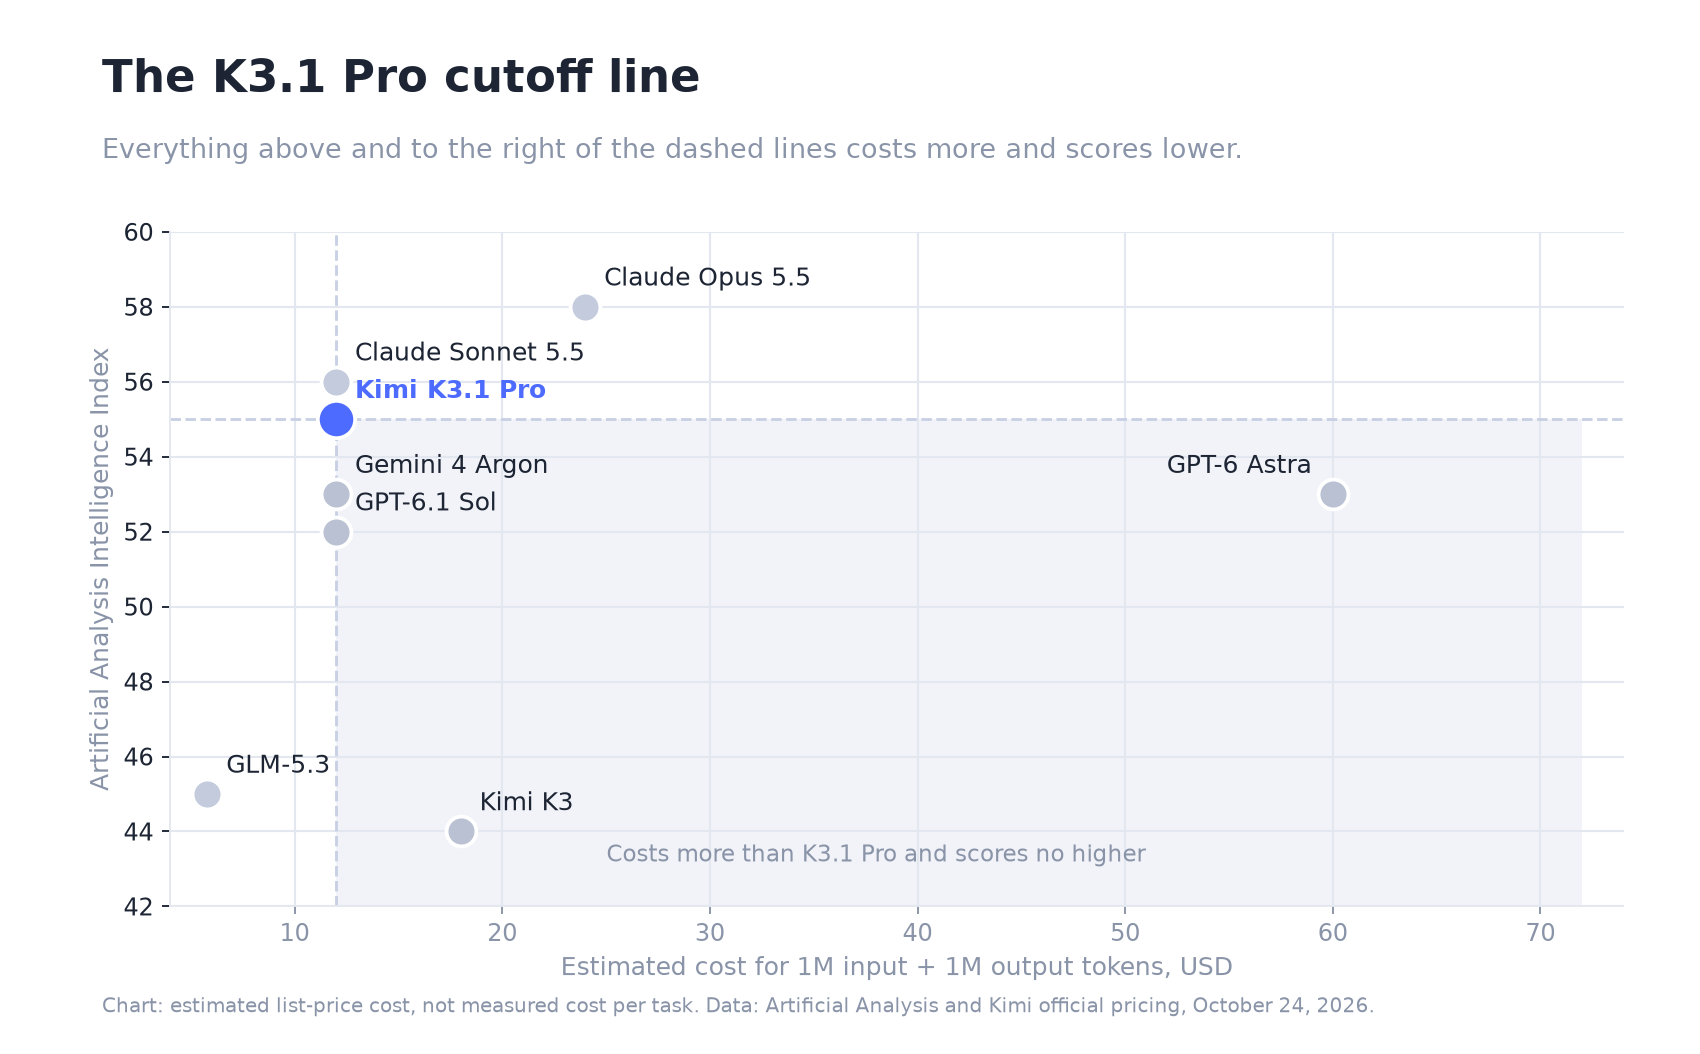
Só dois modelos escapam dessa comparação. O Sonnet 5.5 custa o mesmo e marca um ponto a mais. O Opus 5.5 custa o dobro e marca três pontos a mais. Nenhuma das diferenças é grande, e nenhum dos dois sai barato.
O que ainda não foi comprovado?
A maioria dos números de lançamento vem de testes do próprio fornecedor. OfficeQA Pro v2, SWE Marathon, Agents' Last Exam, os testes de finanças e as demonstrações são todos da Moonshot. Apenas Terminal-Bench 4.0, GDPval-AA, AutomationBench, Arena e a comparação de alucinações são externos. A Moonshot também informa que alguns modelos concorrentes pesquisaram respostas na internet durante o OfficeQA e receberam nota zero, o que reduz seus resultados.
Há duas limitações específicas. No Terminal-Bench Science, a pontuação é 38,1, contra 68,1 do GPT-6 Astra. A velocidade de saída é de cerca de 77 tokens por segundo, contra uma mediana de 81 entre modelos de preço semelhante. Usuários também relatam que a cota de programação de cinco horas se esgota mais rápido do que no K3, o que é compatível com o aumento de 14% no uso de tokens.
Um detalhe incomum: a Moonshot removeu dados de ataques cibernéticos antes do lançamento. Em seu próprio teste de exploração de vulnerabilidades, a versão com esses dados marca 90,5%, e o modelo lançado marca 81,0%, ainda bem acima dos 33,3% do K3. A capacidade foi reduzida de propósito, não perdida.
Vale a pena trocar de modelo?
Para trabalho no terminal, tarefas longas com várias etapas e alterações de código que precisam ser executadas e verificadas, sim, vale testar. Para páginas web avaliadas por pessoas, análises científicas ou respostas que precisam estar certas já na primeira tentativa, o argumento é menos convincente.
Confira quatro pontos nos registros das suas próprias execuções: tokens por tarefa concluída, e não apenas preço por token; se o contexto de 600 mil tokens mantém a qualidade no seu repositório; a latência em relação ao seu limite de tempo; e a velocidade com que a cota do plano se esgota.
Para refatorações rotineiras e documentação, um modelo mais barato ainda faz sentido. A configuração mais comum é dividir o trabalho: DeepSeek V4.1 Flash para chamadas em volume e K3.1 Pro para execuções difíceis de agentes. Para comparar isso com um orçamento fixo de programação, nosso guia do Kimi Coding Plan compara a assinatura e as opções com vários modelos, incluindo as regras de cota.
Veredito
O Kimi K3.1 Pro representa um avanço real, e o método importa mais do que a posição no ranking. Ganhar onze pontos no índice e chegar ao primeiro lugar no Terminal-Bench 4.0 apenas com pós-treinamento, sem aumentar o número de parâmetros e cobrando menos, é um bom resultado para quem paga por token.
Os limites também são claros. Pelo mesmo preço, o Claude Sonnet 5.5 pontua melhor e vence mais votações humanas. Os exemplos de 3D e finanças são, em sua maioria, demonstrações do fornecedor. A conclusão é de um modelo forte para tarefas com agentes, a um preço justo, e não de um novo líder.
Perguntas frequentes
Qual é o identificador do modelo na API?
kimi-k3.1-pro. Ele já está disponível no Kimi.ai, no aplicativo Kimi, no Kimi Work, no Kimi Code e na API do Kimi.
Quanto custa?
Cerca de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, um terço a menos que o K3. Por tarefa concluída, a Artificial Analysis mediu US$ 1,98 contra US$ 2,00, porque o K3.1 Pro usa 14% mais tokens.
Ele supera o GPT-6 e o Gemini 4?
No índice da Artificial Analysis, são 55 pontos contra 53 de ambos. Na votação humana da Arena WebDev, ele fica em oitavo com 1.691 pontos, atrás do GPT-6 Astra, que tem 1.774.