Kimi K3.1 Pro vs. DeepSeek V4.1 Flash: duas formas de pagar por velocidade
Por Cameron Voss
Atualizado em 8 min de leituraComparação de arquitetura e preços
Resumo: O Kimi K3.1 Pro e o DeepSeek V4.1 Flash atendem a tarefas executadas por agentes, mas usam estratégias diferentes para reduzir o custo por etapa. O Kimi mantém um modelo principal e oferece a opção Highspeed, que, segundo a Moonshot, gera a saída de 2 a 3 vezes mais rápido pelo dobro do preço por token. O DeepSeek aposta em uma variante mais leve, com poucos parâmetros ativos por token, entrada em cache a USD 0,006 e preços pela metade fora do horário de pico. O Kimi é uma opção para execuções longas e multimodais; o DeepSeek, para muitas etapas com prefixos repetidos.
Nesta página
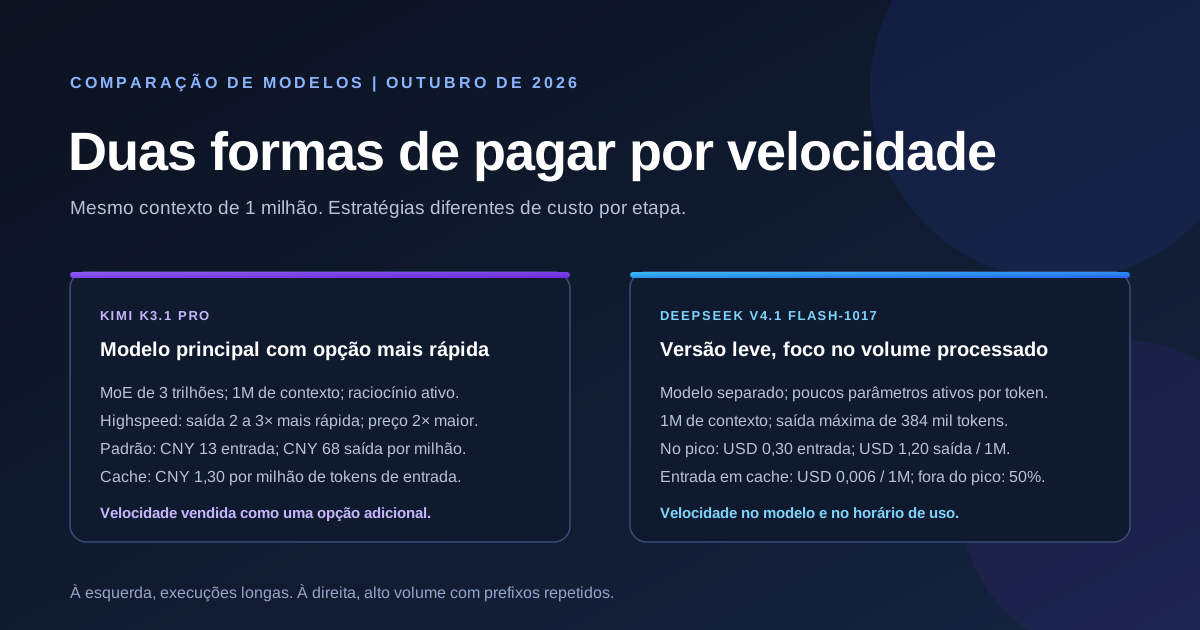
Dois produtos, duas estratégias de velocidade
O Kimi K3.1 Pro foi lançado em 23 de outubro de 2026. É um modelo multimodal com 3 trilhões de parâmetros, contexto de 1 milhão de tokens, raciocínio sempre ativado e uma opção paga chamada Highspeed. O DeepSeek V4.1 Flash-1017 foi lançado em 17 de outubro e é acessado pelo identificador deepseek-flash. Trata-se de uma variante leve e separada, com o mesmo contexto de 1 milhão de tokens e limite de saída de 384 mil tokens.
As janelas de contexto são iguais, mas as prioridades de projeto são diferentes. O Kimi oferece menor latência como uma segunda opção de serviço. O DeepSeek usa um modelo mais barato e cobra conforme o uso do cache e o horário.
Comparação rápida
| Característica | Kimi K3.1 Pro | DeepSeek V4.1 Flash-1017 |
|---|---|---|
| Fornecedor | Moonshot AI | DeepSeek |
| ID do modelo | kimi-k3.1-prokimi-k3.1-pro-highspeed | deepseek-flash |
| Lançamento | 23 de outubro de 2026 | 17 de outubro de 2026 |
| Arquitetura | MoE multimodal com 3 trilhões de parâmetros | MoE esparso, variante leve |
| Contexto | 1 milhão de tokens | 1 milhão de tokens |
| Saída máxima | 131.072 por padrão; até 1.048.576 com max_completion_tokens | 384 mil tokens |
| Modo de raciocínio | Sempre ativado. reasoning_effort: low, high ou max; padrão: max | Parâmetros thinking e reasoning_effort |
| Preço da API por milhão de tokens | Padrão: CNY 13,00 entrada; CNY 1,30 em cache; CNY 68,00 saída Highspeed: CNY 26,00; CNY 1,30; CNY 136,00 | Pico: USD 0,30 entrada; USD 0,006 em cache; USD 1,20 saída Fora do pico: 50% desses valores |
| Estratégia de velocidade | Segundo a Moonshot, a Highspeed gera a saída de 2 a 3 vezes mais rápido que a versão padrão | Projeto voltado ao volume processado |
| Uso prioritário | Execuções longas e multimodais em uma única sequência de etapas | Muitas etapas com prefixos repetidos |
O número de parâmetros ativos descreve o processamento por token, não a memória necessária para carregar o modelo. A liberação dos pesos do Kimi está prevista para antes de 4 de novembro; o DeepSeek V4.1 Flash-1017 já tem pesos disponíveis sob a licença MIT.
Se você quer experimentar o Kimi K3.1 Pro por meio de um plano de programação, nosso guia do Coding Plan Kimi explica a seleção do modelo e os requisitos da conta.
Como cada modelo ganha velocidade
Kimi K3.1 Pro
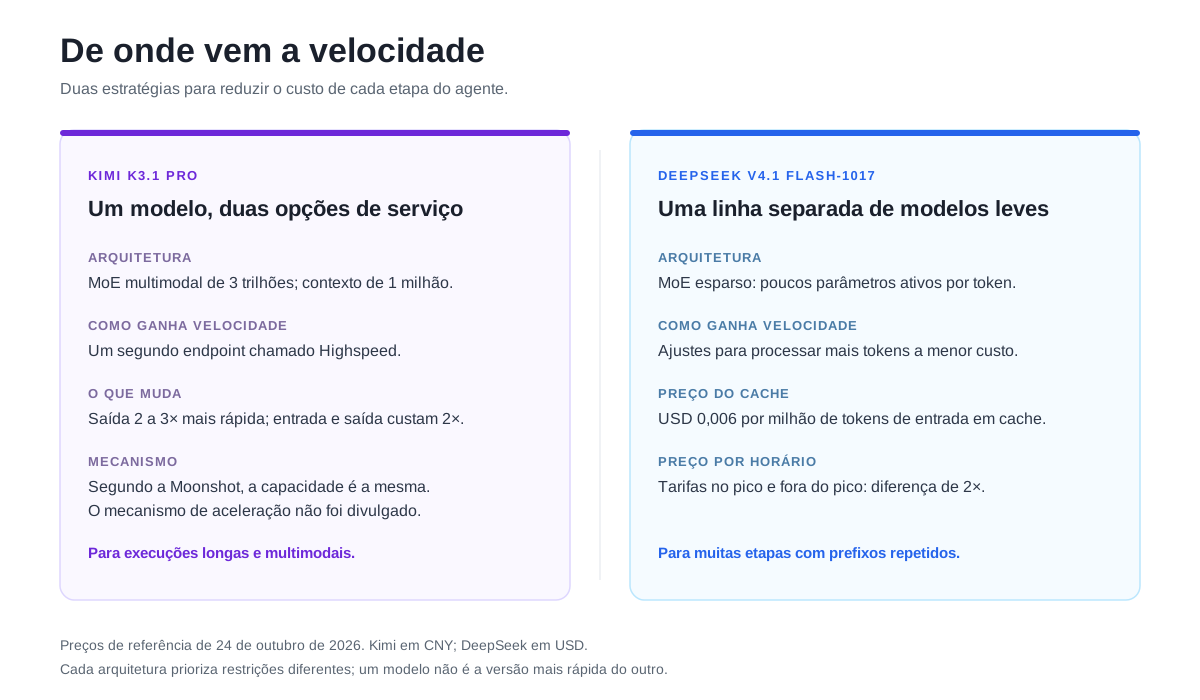
O Kimi não reduz o tamanho do modelo para ganhar velocidade. Ele mantém o mesmo modelo de 3 trilhões de parâmetros e oferece um segundo endpoint. A Moonshot afirma que a Highspeed tem a mesma capacidade e gera a saída de 2 a 3 vezes mais rápido, cobrando exatamente o dobro pela entrada e pela saída. As leituras do cache continuam custando CNY 1,30. O mecanismo de inferência não foi divulgado, por isso a Highspeed deve ser entendida como uma opção de serviço, e não como outro modelo.
A operação continua simples: um modelo, duas velocidades e um preço de leitura do cache. A opção mais rápida custa mais. As condições da assinatura do Kimi Code são diferentes das condições de acesso à API com cobrança por uso.
DeepSeek V4.1 Flash
O Flash não é apenas um endpoint mais rápido de um modelo existente. É uma variante leve e separada, ajustada para processar mais tokens a um custo unitário menor. Sua arquitetura esparsa de mistura de especialistas ativa apenas parte do modelo a cada token. O número de parâmetros ativos, por si só, não determina a latência nem o custo de concluir uma tarefa.
Os preços seguem a mesma lógica. A entrada em cache custa USD 0,006 por milhão de tokens, ou 2% da tarifa de entrada no pico. Os horários de pico são das 01:00 às 04:00 e das 06:00 às 10:00 UTC, de segunda a sexta-feira, exceto nos feriados nacionais chineses; em todos os outros horários, o preço cai pela metade. Uma janela de contexto longa, por si só, não garante desempenho confiável ao longo de uma execução extensa de um agente.
Quanto custa um mês de uso
No Kimi, a principal variável é a latência. No DeepSeek, são o horário e o cache. A tabela considera 1 bilhão de tokens de entrada e 100 milhões de tokens de saída, com os preços de referência de 24 de outubro fornecidos para este artigo. Os valores estimam cobranças por tokens; não são medições de custo por tarefa nem representam uma fatura completa.
| Cenário | Entrada | Saída | Subtotal de tokens |
|---|---|---|---|
| Kimi padrão, sem cache | CNY 13.000 | CNY 6.800 | CNY 19.800 |
| Kimi padrão, 90% de acerto no cache | CNY 2.470 | CNY 6.800 | CNY 9.270 |
| Kimi Highspeed, sem cache | CNY 26.000 | CNY 13.600 | CNY 39.600 |
| DeepSeek no pico, sem cache | USD 300,00 | USD 120,00 | USD 420,00 |
| DeepSeek no pico, 90% de acerto no cache | USD 35,40 | USD 120,00 | USD 155,40 |
| DeepSeek fora do pico, sem cache | USD 150,00 | USD 60,00 | USD 210,00 |
Cálculos feitos a partir dos preços de referência fornecidos, não de medições de custo por tarefa. Os cenários com cache pressupõem uma taxa de acerto de 90%. Os valores não incluem cobranças de gravação no cache do Kimi, uso de ferramentas nem impostos. CNY e USD são mantidos separados, sem conversão cambial.
No Kimi, a leitura da entrada em cache custa 10% da tarifa de entrada padrão. No DeepSeek, custa 2%. Se o seu agente repete um prompt de sistema longo, os dois fornecedores oferecem economia. Se o prefixo muda a cada etapa, o benefício do cache é pequeno em ambos.
Ferramentas e busca na web
As duas APIs permitem chamadas de ferramentas. O Kimi também documenta ferramentas oficiais de busca, mas o guia de início rápido do K3.1 Pro recomenda, no momento, não usar a busca na web em produção enquanto ela passa por atualização. O DeepSeek oferece APIs separadas de Search e Fetch. A disponibilidade de uma ferramenta em um aplicativo de programação é diferente do suporte oferecido pela API do modelo; verifique a integração que você realmente usa.
Qual modelo combina com cada tipo de tarefa
O Kimi é uma opção para execuções longas com entradas multimodais: trabalho em bases de código, tarefas de CAD ou 3D, revisão de documentos financeiros e equipes que precisam de uma opção mais rápida em determinados momentos. Como o raciocínio fica sempre ativado, até as tarefas curtas incluem esse custo.
O DeepSeek combina com muitas etapas curtas: classificação em lote, extração de dados, revisão arquivo por arquivo, triagem de logs e distribuição do trabalho entre várias execuções paralelas. Programar tarefas fora do pico e aproveitar o cache de prefixos pesa mais nessa escolha do que concentrar o trabalho em uma única execução longa. Uma divisão comum é usar os dois: o modelo principal para planejamento e etapas multimodais difíceis, e o modelo leve para execução em volume.
As limitações de cada modelo
Kimi K3.1 Pro
- A liberação dos pesos está prevista para antes de 4 de novembro de 2026; a licença e os requisitos de hardware ainda não são conhecidos. Hospedar um modelo de 3 trilhões de parâmetros não é uma opção viável para a maioria das equipes.
- O raciocínio não pode ser desativado. É possível reduzir
reasoning_effortpara low, mas o padrão é max. - Nos preços de referência fornecidos, a Highspeed cobra o dobro pela entrada e pela saída. As condições da assinatura do Kimi Code são diferentes das condições de acesso à API com cobrança por uso.
DeepSeek V4.1 Flash
- Um contexto longo não garante execuções extensas confiáveis. Compare as taxas de conclusão e as novas tentativas no ambiente de execução do seu agente.
- Os pesos estão disponíveis sob a licença MIT. A hospedagem própria ainda exige uma avaliação separada de hardware e implantação.
- O preço dobra nos horários de pico dos dias úteis, e os resultados de versões preliminares anteriores do Flash não podem ser atribuídos ao V4.1 Flash-1017.
Perguntas frequentes
O Kimi K3.1 Pro tem pesos abertos?
Ainda não. A Moonshot afirma que os pesos completos serão publicados antes de 4 de novembro de 2026. A licença, o local de download e os requisitos de hardware ainda não foram anunciados.
Posso desativar o raciocínio no Kimi K3.1 Pro?
Não. O modelo funciona apenas com o modo de raciocínio ativado. Você pode definir reasoning_effort como low, high ou max; o padrão é max.
Esses modelos fazem buscas na web por conta própria?
A busca exige a integração de uma ferramenta. O Kimi documenta ferramentas de busca, mas recomenda, no momento, não usá-las em produção enquanto passam por atualização. O DeepSeek oferece APIs separadas de Search e Fetch. O ambiente de execução do agente controla quando as ferramentas são chamadas.
Qual dos dois custa menos?
A tabela mantém CNY e USD separados, por isso não aponta um vencedor após conversão cambial. O DeepSeek oferece preços pela metade fora do horário de pico; o Kimi cobra mais pela Highspeed nos preços de referência fornecidos. Para comparar o custo da sua operação, considere as tarifas convertidas, a gravação no cache, o tamanho das saídas e as novas tentativas.