Kimi K3.1 Pro vs Gemini 4 Argon: duas formas de oferecer um modelo de ponta
Por Cameron Voss
Atualizado em 5 min de leitura
Resumo: Os dois são modelos de ponta, mas organizam de forma diferente a relação entre velocidade e custo. O Kimi K3.1 Pro, da Moonshot, oferece o mesmo modelo em duas opções de serviço: segundo a empresa, o Highspeed gera a saída de 2 a 3 vezes mais rápido e cobra o dobro por token. O Gemini 4 Argon usa um único endpoint principal, com latência e custo ajustados pelo nível de raciocínio e pela modalidade de serviço da API. No Kimi, você escolhe o ID do modelo a cada requisição. No Argon, ajusta o esforço de raciocínio e o nível de serviço.
Nesta página
O que cada empresa lançou
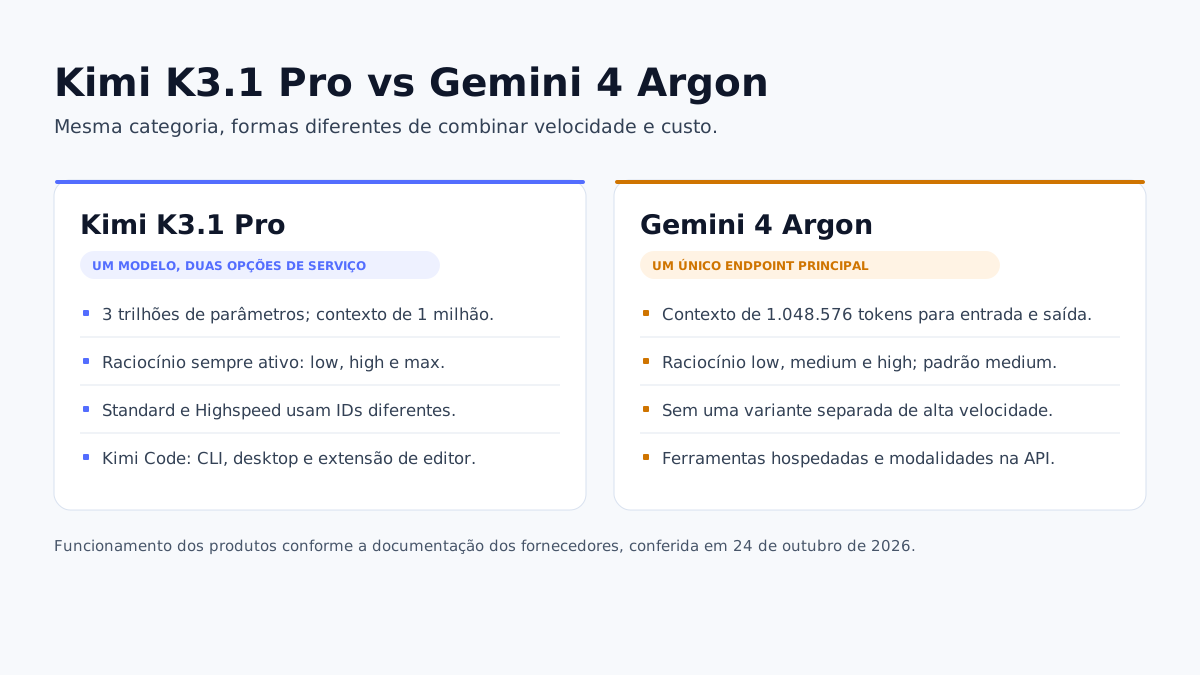
A Moonshot lançou o Kimi K3.1 Pro em 23 de outubro de 2026. O modelo pertence à categoria de 3 trilhões de parâmetros e tem uma janela de contexto de 1 milhão de tokens. A empresa o posiciona para programação, modelagem 3D, pesquisa financeira e execuções longas de agentes. O raciocínio fica sempre ativo: é possível ajustar o esforço para low, high ou max, mas não desativá-lo.
O Google anunciou o Gemini 4 Argon em 30 de setembro de 2026 e liberou o acesso para desenvolvedores pela API Gemini em 13 de outubro. O Argon é o principal modelo de raciocínio do Google. A API informa um contexto de 1.048.576 tokens, compartilhado entre entrada e saída, com os níveis de raciocínio low, medium e high. O padrão da API é medium.
| Item | Kimi K3.1 Pro | Gemini 4 Argon |
|---|---|---|
| Empresa | Moonshot AI | |
| IDs dos modelos | kimi-k3.1-prokimi-k3.1-pro-highspeed | gemini-4-argon |
| Posicionamento | Modelo de ponta para programação, trabalho em 3D e tarefas longas de agentes | Modelo de raciocínio de ponta para trabalhos longos e com várias etapas |
| Contexto | 1 milhão de tokens | 1.048.576 tokens, compartilhados entre entrada e saída |
| Pesos abertos | Pesos completos previstos para 4 de novembro de 2026; licença pendente | Pesos não disponibilizados de forma aberta |
| Entrada multimodal | Texto, esboços e imagens de referência | Texto, imagens, vídeo, áudio e PDF |
| Controle do raciocínio | Low, high e max. Não pode ser desativado | Low, medium e high. Medium é o padrão |
| Opção de velocidade | Um segundo ID de modelo: Highspeed | Sem uma versão separada de alta velocidade |
| Moeda da API | CNY | USD |
| Ferramentas disponíveis | Kimi Code para desktop, CLI e extensão de editor; MCP e plugins | Chamadas de funções na API Gemini; fundamentação com a Pesquisa Google, contexto de URLs e execução de código |
Documentação dos fornecedores conferida em 24 de outubro de 2026. O Argon permite uma janela de saída de 1 milhão de tokens, mas a saída síncrona padrão é limitada a 65.536 tokens.
A diferença de produto: uma opção de velocidade ou um único endpoint
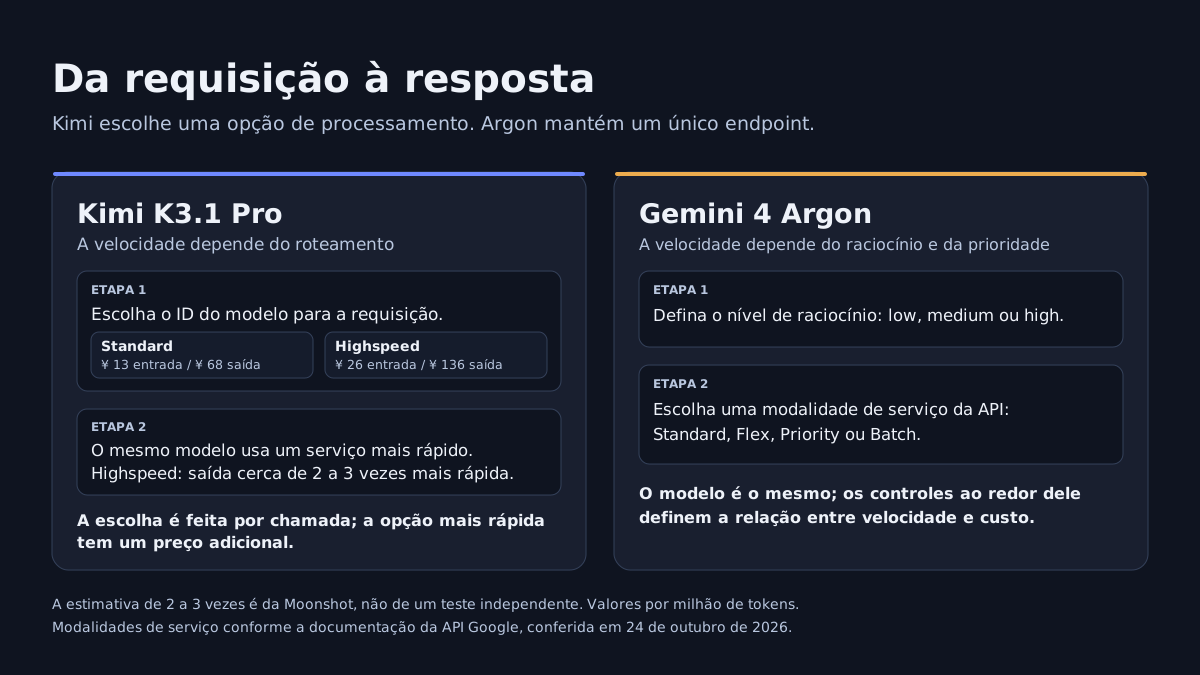
O Kimi trata a velocidade como uma escolha de produto. O K3.1 Pro e o K3.1 Pro Highspeed executam o mesmo modelo. O Highspeed usa uma modalidade de processamento mais rápida que, segundo a Moonshot, gera a saída cerca de 2 a 3 vezes mais rápido e custa o dobro por token de entrada e saída. Essa relação entre custo e velocidade é definida na escolha do ID do modelo.
O Google não divide o Argon em uma versão padrão e outra rápida. Há um único ID de modelo, com ajustes ao redor dele: quanto raciocínio o modelo faz e qual modalidade de serviço da API processa a requisição. O Google documenta as modalidades Standard, Flex, Priority e Batch, cada uma com suas tarifas. Para reduzir a latência, a equipe ajusta esses controles em vez de trocar de modelo.
O Kimi cobra pela velocidade escolhida em cada requisição. O Argon faz isso por meio das modalidades de serviço.
Onde as ferramentas entram no fluxo
O Kimi K3.1 Pro é oferecido com um ambiente de execução de agentes, ou harness, além do endpoint. O Kimi Code tem um aplicativo para desktop, uma CLI e uma extensão para o VS Code. O ambiente inclui ferramentas para arquivos, shell, mídia, web e agendamento, além de servidores MCP, plugins, hooks e subagentes. A API aceita os protocolos Responses, chat-completion e message, permitindo usar o mesmo modelo em diferentes frameworks de agentes.
O Argon funciona dentro da própria API do Google. A documentação da API Gemini descreve chamadas de funções e ferramentas hospedadas, como fundamentação com a Pesquisa Google, contexto de URLs e execução de código. O Argon também aceita texto, imagens, vídeo, áudio e PDF como entrada. A aplicação monta o ciclo de chamadas às ferramentas, enquanto as ferramentas hospedadas do Google cuidam da busca e da execução quando são ativadas.
O Kimi fornece uma parte maior desse fluxo. O Argon deixa a orquestração para a sua aplicação.
Como funciona a cobrança de cada modelo
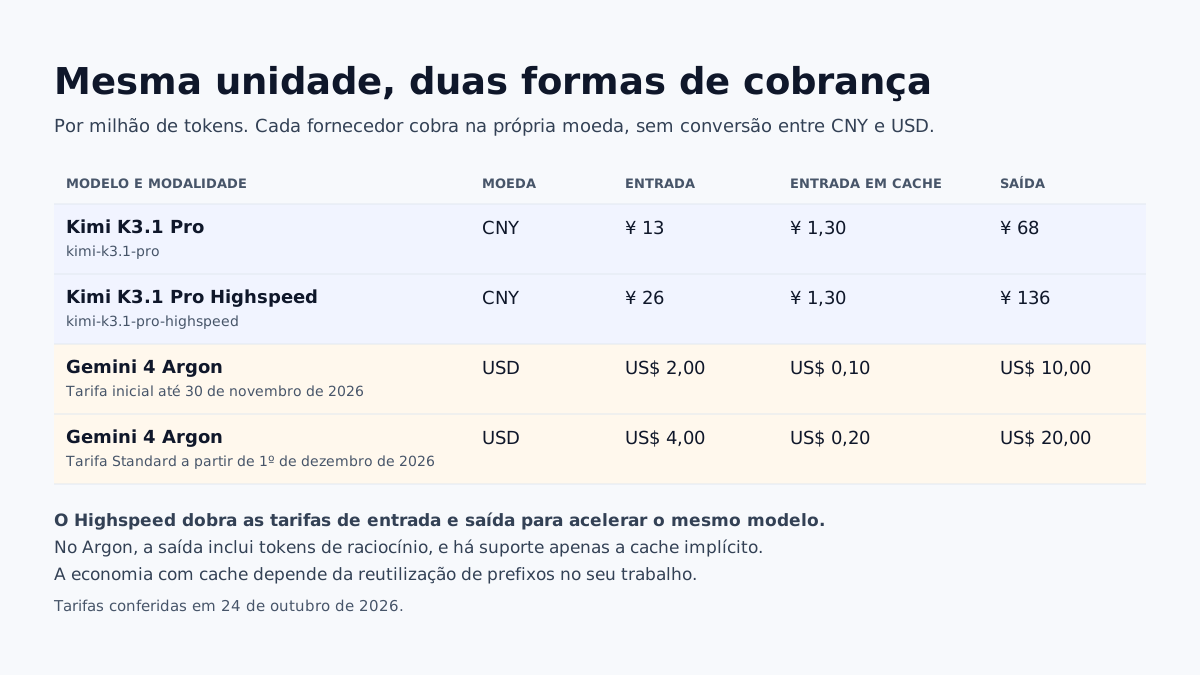
A tabela de preços do Kimi acompanha a escolha do modelo. Na opção Standard, a entrada custa ¥ 13 e a saída, ¥ 68 por milhão de tokens. O Highspeed dobra esses valores para ¥ 26 e ¥ 136, enquanto a entrada em cache permanece em ¥ 1,30. Como o raciocínio não pode ser desativado, execuções longas de raciocínio aumentam o volume de saída. No Kimi Code, o contexto de 1 milhão de tokens e o Highspeed exigem planos de assinatura superiores. A plataforma Kimi API é separada e cobra por uso, sem exigir uma assinatura do Kimi Code.
O Argon tem um único modelo com preços promocionais por tempo limitado. A tarifa inicial da modalidade Standard é de US$ 2 para entrada, US$ 0,10 para entrada em cache e US$ 10 para saída por milhão de tokens até 30 de novembro de 2026. Em 1º de dezembro, os valores passam a US$ 4, US$ 0,20 e US$ 20. A cobrança de saída inclui tokens de raciocínio, e o modelo aceita apenas cache implícito. Ferramentas hospedadas e modalidades de serviço têm cobrança própria.
Uma estimativa para o Kimi começa pelo ID do modelo. Para o Argon, começa pelo esforço de raciocínio e pela modalidade de serviço.
| Modelo e modalidade | Moeda | Entrada | Entrada em cache | Saída |
|---|---|---|---|---|
| Kimi K3.1 Pro | CNY | ¥ 13 | ¥ 1,30 | ¥ 68 |
| Kimi K3.1 Pro Highspeed | CNY | ¥ 26 | ¥ 1,30 | ¥ 136 |
| Gemini 4 Argon, tarifa inicial até 30 de novembro | USD | US$ 2,00 | US$ 0,10 | US$ 10,00 |
| Gemini 4 Argon, tarifa Standard a partir de 1º de dezembro | USD | US$ 4,00 | US$ 0,20 | US$ 20,00 |
Preços por 1 milhão de tokens, sem conversão entre as moedas. A tarifa de entrada em cache só se aplica quando o trabalho de fato reutiliza um prefixo. Na API Kimi K3, a gravação em cache é cobrada separadamente conforme o tempo de retenção; esses custos não estão incluídos na tabela.
Qual modelo combina com cada tipo de tarefa
O Kimi K3.1 Pro tende a atender bem à programação interativa e ao trabalho com agentes quando a equipe quer manter uma única família de modelos e escolher a latência a cada requisição. O ambiente do Kimi Code faz parte da oferta, então não é necessário desenvolver do zero o acesso ao shell, a edição de arquivos e as ferramentas MCP. Ao deixar as chamadas rotineiras em Standard e reservar o Highspeed para etapas sensíveis à latência, a equipe tem um preço claro para essa escolha.
O Gemini 4 Argon tende a se encaixar em trabalhos que já usam a API do Google: análise de documentos e conteúdo multimodal, respostas fundamentadas em buscas, execução de código e fluxos com várias etapas nos quais a aplicação orquestra as ferramentas. O endpoint único simplifica a escolha do modelo, e os níveis de raciocínio permitem usá-lo tanto em etapas leves quanto nas mais exigentes.
Equipes que lidam com os dois tipos de trabalho podem distribuir as tarefas conforme suas características.
Limitações que vale avaliar antes de escolher
Kimi K3.1 Pro:
- A liberação dos pesos completos estava prevista para 4 de novembro de 2026. Em 24 de outubro, os termos da licença e os requisitos de hardware ainda não haviam sido publicados.
- O raciocínio não pode ser desativado, então mesmo tarefas curtas passam por essa etapa.
- O Highspeed dobra o preço dos tokens de entrada e saída.
- No Kimi Code, o contexto de 1 milhão de tokens e o Highspeed exigem planos de assinatura superiores.
Gemini 4 Argon:
- As tarifas iniciais terminam em 30 de novembro de 2026.
- A cobrança de saída inclui os tokens de raciocínio.
- Há suporte apenas a cache implícito. A gravação explícita em cache não está disponível.
- Não há uma versão separada de alta velocidade; as opções de latência dependem do nível de raciocínio e da modalidade de serviço.
- Ferramentas hospedadas e modalidades de serviço têm tarifas próprias.
Se a escolha de velocidade por requisição do Kimi combina com o seu fluxo de programação, você pode experimentar o Kimi K3.1 Pro pelo nosso Kimi Coding Plan. O guia do Kimi Coding Plan, em inglês, explica a configuração atual e os limites do plano.