Kimi K3.1 Pro vs GPT-6.1 Sol: duas formas de acelerar LLMs para agentes
Por Cameron Voss
Atualizado em
ResumoKimi K3.1 Pro e GPT-6.1 Sol buscam reduzir o custo das tarefas executadas por agentes, mas seguem caminhos opostos. A Moonshot mantém um único modelo da classe de 3 trilhões de parâmetros, com contexto de até 1 milhão de tokens nos planos superiores, e vende mais velocidade como uma opção adicional de serviço. A OpenAI lança o Sol como um modelo mais leve, ajustado de forma independente, com preços de US$ 2,00 para entrada e US$ 10,00 para saída por milhão de tokens. O Kimi se encaixa em sessões longas, com muito contexto; o Sol, em ciclos curtos e de alto volume.
Neste artigo
O Kimi K3.1 Pro chegou ao Kimi Code em 23 de outubro de 2026. O GPT-6.1 Sol foi lançado na atualização da OpenAI de 29 de setembro. Ambos são oferecidos para agentes de programação e uso prolongado de ferramentas. A diferença que merece atenção é onde cada empresa faz o trabalho de reduzir o custo do agente.
O que cada produto oferece
O K3.1 Pro é o primeiro modelo da série K3.1 da Moonshot. Trata-se de um modelo da classe de 3 trilhões de parâmetros, obtido por pós-treinamento do Kimi K3, com foco declarado em programação, trabalho em 3D, pesquisa financeira e tarefas longas de agentes. O acesso ocorre pelo aplicativo Kimi, pelos clientes do Kimi Code e pela API. A publicação dos pesos completos foi prometida para até 4 de novembro de 2026, e a licença ainda não foi divulgada.
O Sol é um modelo mais leve da linha GPT-6 da OpenAI, posicionado abaixo do Astra. O anúncio da OpenAI o apresenta para programação com agentes, uso do computador e trabalho profissional. No lançamento, ele estava disponível pela API, no ChatGPT Work e no Codex, em planos pagos específicos, mas não no Chat. Uma opção Ultrafast foi anunciada para depois.
| Característica | Kimi K3.1 Pro | GPT-6.1 Sol |
|---|---|---|
| Fornecedor | Moonshot AI | OpenAI |
| Lançamento | 23 de outubro de 2026, no Kimi Code | 29 de setembro de 2026 |
| Posicionamento | Modelo principal da série K3.1 | Modelo mais leve, abaixo do Astra |
| Como ganha velocidade | Segunda opção de serviço: geração de saída 2 a 3 vezes mais rápida, pelo dobro do preço | Modelo menor, ajustado separadamente |
| Contexto | Até 1 milhão de tokens nos planos superiores | Não informado no material de lançamento consultado |
| Raciocínio | Sempre ativo; low, high ou max; padrão: max | Configurado por requisição; não fica sempre ativo |
| Pesos | Prometidos para até 4 de novembro de 2026; licença pendente | Proprietários |
| Preço da API por milhão de tokens | CNY 13,00 de entrada; CNY 1,30 de entrada em cache; CNY 68,00 de saída | US$ 2,00 de entrada; US$ 0,10 de entrada em cache; US$ 10,00 de saída |
Os valores são os preços de tabela publicados: Moonshot AI, outubro de 2026; OpenAI, 29 de setembro de 2026. As moedas não foram convertidas.
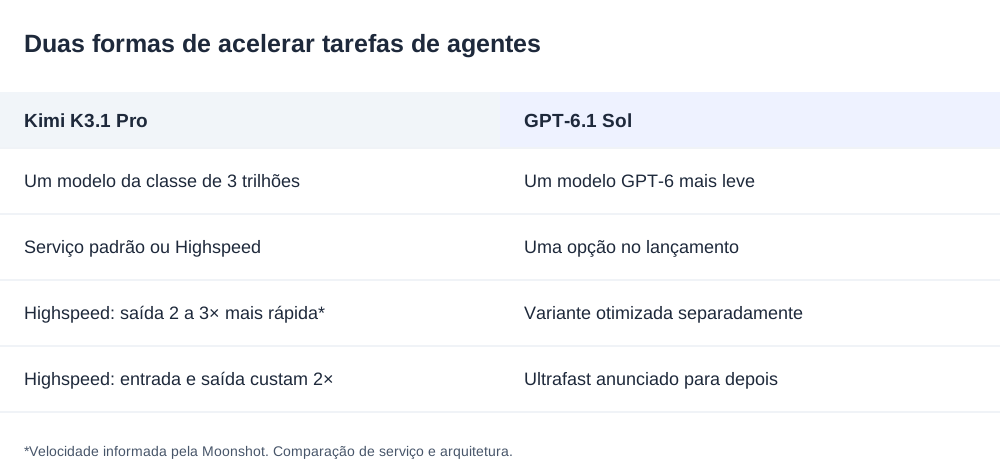
De onde vem a velocidade?
Kimi K3.1 Pro: manter o modelo, dividir o serviço
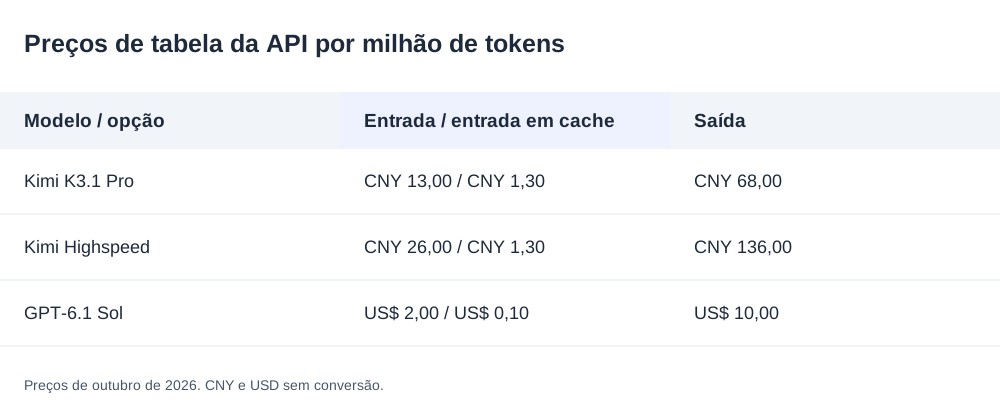
A Moonshot manteve o modelo grande e transformou a velocidade em uma decisão de roteamento. O K3.1 Pro tem dois IDs na API. O kimi-k3.1-pro custa CNY 13,00 para entrada e CNY 68,00 para saída por milhão de tokens. O kimi-k3.1-pro-highspeed custa CNY 26,00 e CNY 136,00, com geração de saída cerca de 2 a 3 vezes mais rápida, segundo a Moonshot. A leitura de cache permanece em CNY 1,30 nas duas opções.
A vantagem é poder escolher caso a caso. Uma equipe pode enviar uma edição interativa para o Highspeed e um lote noturno para a opção padrão, usando o mesmo modelo nas duas situações. Em contrapartida, a velocidade custa o dobro por token, e alguém precisa cuidar da lógica de roteamento.
O raciocínio está sempre ativo. A API aceita reasoning_effort com os valores low, high ou max, usa max como padrão e retorna erro 400 se o raciocínio for desativado. Isso impõe um consumo mínimo de tokens a cada chamada, inclusive nas mais simples.
GPT-6.1 Sol: reduzir o próprio modelo
A OpenAI concentrou o trabalho no modelo. O Sol é uma variante menor, otimizada separadamente, em vez de um modo rápido do Astra. Assim, a economia aparece antes do envio da requisição: um preço de tabela menor e respostas mais rápidas, com um limite de capacidade abaixo do modelo principal.
Não há um botão para ativar o Highspeed. Na linha da OpenAI, gastar menos ou ganhar velocidade exige escolher outro modelo. Isso torna a decisão uma escolha feita para aquela carga de trabalho, em vez de um ajuste por requisição, e mantém o ambiente de execução consistente depois da escolha.
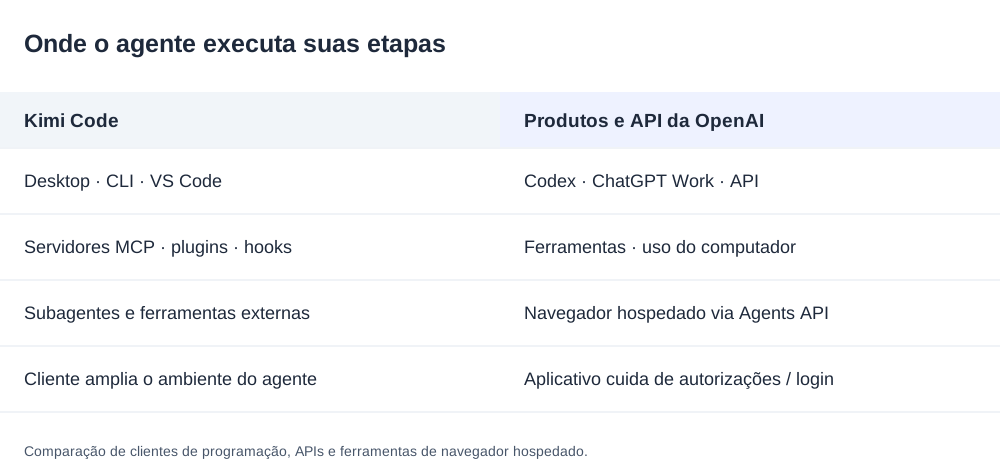
Onde o agente executa suas etapas?
O K3.1 Pro vem com um ambiente de execução que o cliente pode ampliar. O Kimi Code está disponível como aplicativo de desktop, CLI e extensão do VS Code, com servidores MCP, plugins, hooks e subagentes para adaptar o ciclo de execução. A Moonshot recomenda seus protocolos nativos de Responses, chat completion e mensagens, e alerta que a conversão de protocolos por proxies pode alterar os resultados. O modelo também foi pensado para operar ferramentas externas, como Blender, CAD e motores de jogos.
A OpenAI mantém uma parte maior desse ciclo no próprio ambiente de execução. Chamadas de ferramentas e uso do computador são expostos pela API, e o Sol foi lançado no Codex e no ChatGPT Work. O registro de alterações da API de 29 de setembro adicionou à Agents API o uso de um navegador hospedado, cabendo ao aplicativo que faz a integração cuidar das autorizações de acesso aos sites e do login. Quem segue esse caminho recebe um ambiente gerenciado e precisa integrar menos peças, dentro dos limites dos produtos da OpenAI.
O que entra na conta?
As duas empresas dão desconto para entrada em cache, mas em proporções diferentes. No K3.1 Pro, um token em cache custa cerca de 10% de um token de entrada novo; no Sol, 5%. Isso faz diferença para agentes que reenviam um prefixo longo a cada etapa, como ocorre na maioria dos casos.
O Kimi Code acrescenta outra forma de cobrança. O K3.1 Pro exige Plus ou Moderato, ou um plano superior; já a janela de contexto de 1 milhão de tokens e o Highspeed exigem Pro ou Allegretto, ou um plano superior. Para quem programa individualmente, o custo efetivo passa a depender da escolha da assinatura, em vez de uma simples multiplicação por tokens. A API continua sendo cobrada por uso.
Se você quer testar o K3.1 Pro, nosso Kimi Coding Plan é uma opção para começar. O guia do Kimi Coding Plan explica os IDs dos modelos, os limites de cada opção e os passos de configuração para executar uma tarefa real.
Qual abordagem combina com cada tarefa?
- Refatorações longas e trabalho em todo o repositório: a janela de contexto de 1 milhão de tokens e o raciocínio sempre ativo do K3.1 Pro combinam com sessões que percorrem muitos arquivos. O Highspeed ajuda quando a pessoa está esperando uma edição ficar pronta.
- Tarefas em lote com interações curtas: a opção única e o preço de tabela menor do Sol simplificam as estimativas, pois não há uma decisão de roteamento a cada requisição.
- Trabalho em 3D, CAD e motores de jogos: as notas de lançamento da Moonshot destacam esses usos para o K3.1 Pro.
- Uso do computador com autorizações: o navegador hospedado do Sol funciona na infraestrutura da OpenAI, enquanto o aplicativo que faz a integração continua responsável pelas autorizações e pelo login.
- Equipes que já pagam por planos da OpenAI: o Sol aparece nos produtos que elas já usam. Quem compra o Kimi Code recebe o K3.1 Pro por meio de um plano de assinatura.
As duas abordagens permitem uma configuração mista. Sessões longas e caras podem ir para o K3.1 Pro, enquanto tarefas curtas e repetitivas vão para o Sol, com cada modelo avaliado para a função que vai cumprir.
Quais são as limitações de cada abordagem?
O K3.1 Pro paga pela flexibilidade em alguns pontos. O raciocínio sempre ativo aumenta o consumo mínimo de tokens em prompts simples. O Highspeed dobra o preço da entrada e da saída, mas não o do cache. A janela de 1 milhão de tokens e o Highspeed ficam nos planos de assinatura superiores. Os arquivos de pesos ainda não foram publicados e são grandes: a licença não foi divulgada, e um modelo da classe de 3 trilhões de parâmetros está muito além de um notebook. A Moonshot também aponta a conversão de protocolos por proxies como um risco para a estabilidade, o que impõe mais uma restrição à construção do ambiente do agente.
O Sol abre mão de capacidade máxima e flexibilidade. Não há uma opção de velocidade que mantenha a capacidade do modelo principal: para ser mais rápido, o modelo é menor. O anúncio da OpenAI não informa a janela de contexto do Sol, então esse limite precisa ser consultado na documentação atual, e não no anúncio. O acesso pelo Chat não estava disponível no lançamento, e o Ultrafast foi anunciado para depois. O ambiente gerenciado também define onde as ferramentas e as autorizações podem funcionar.
Perguntas frequentes
O Kimi K3.1 Pro é de código aberto?
Ainda não. A Moonshot afirma que os pesos completos serão publicados até 4 de novembro de 2026, e a licença ainda não foi divulgada. Até lá, o modelo está disponível pelos produtos da Kimi e pela API.
Posso desativar o modo de raciocínio no Kimi K3.1 Pro?
Não. A API retorna erro 400 quando o raciocínio é desativado. O parâmetro reasoning_effort aceita low, high ou max, e o padrão é max.
O GPT-6.1 Sol tem uma opção mais rápida, como o Kimi Highspeed?
Não. No lançamento, o Sol tem uma única opção de preço. A OpenAI anunciou uma opção Ultrafast para o modelo, prevista para depois.
Qual modelo custa menos por token?
Não existe um número único, porque as empresas cobram em moedas diferentes. A Kimi lista CNY 13,00 para entrada e CNY 68,00 para saída por milhão de tokens na opção padrão. O Sol lista US$ 2,00 para entrada e US$ 10,00 para saída. A entrada em cache custa cerca de 10% da tarifa de entrada no K3.1 Pro e 5% no Sol.
Fontes: Moonshot AI, notas de lançamento do Kimi K3.1 Pro e tabela de preços da API, outubro de 2026.