Aktualisiert am 5. November 2026
Moonshot veröffentlicht die Gewichte von Kimi K3.1 Pro: Was bedeutet das für Entwickler?
Von Cameron Voss
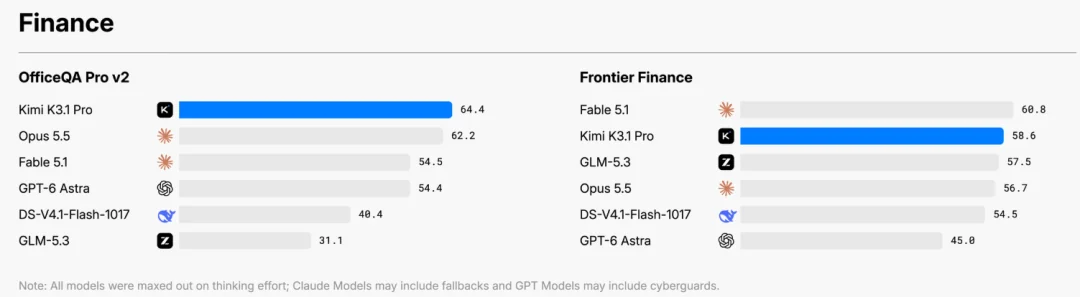
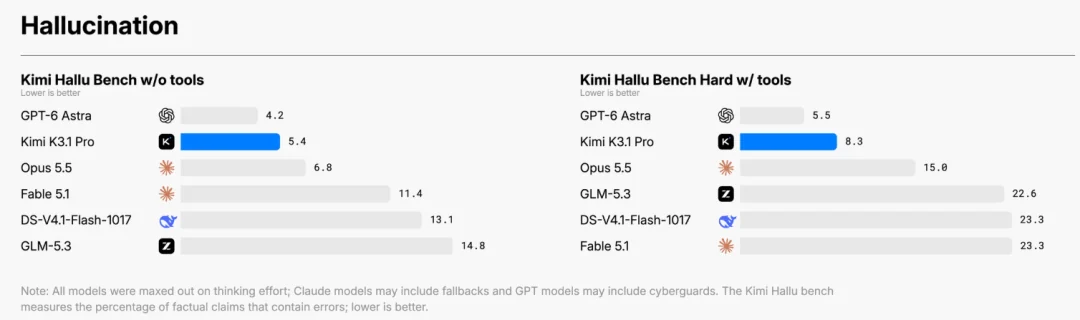
KurzfassungMoonshot hat die Gewichte von Kimi K3.1 Pro veröffentlicht: ein Mixture-of-Experts-Modell mit 2,8 Billionen Parametern und einem Kontextfenster von einer Million Tokens. Es erreicht 65,7 % bei Terminal-Bench 4.0, gegenüber 66,4 % für Claude Opus 5.5 und 58,2 % für GPT-6 Astra. Mit Werkzeugen erzielt es 92,7 bei BenchCAD (Opus 5.5: 96,2) und 64,4 bei OfficeQA Pro v2. Die Halluzinationsrate pro Aussage sinkt von 23,4 % bei K3 auf 8,3 %. Offene Gewichte machen die Inferenz nicht günstig: Bei dieser Größe werden die meisten Teams einen gehosteten Dienst nutzen.
Die Gewichte liegen auf Hugging Face unter moonshotai/Kimi-K3.1-Pro. Der NVIDIA-AI-Account gratulierte dem Team am selben Morgen; einige Entwickler bezeichneten die Veröffentlichung als Modell der Fable-Klasse, das nun heruntergeladen werden kann.
Für Entwickler und Betreiber von Agenten sind die Fragen konkreter: Unter welchen Bedingungen gelten die Zahlen, und was passiert beim Einsatz in einem echten Arbeitsablauf?
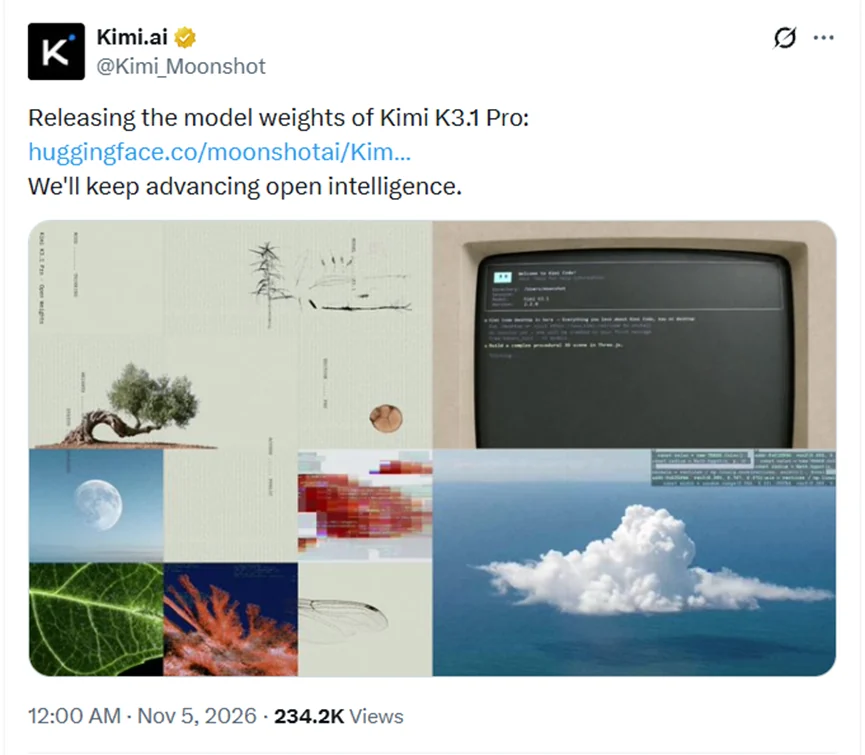
Was hat Moonshot veröffentlicht?
Ein Mixture-of-Experts-Modell mit 2,8 Billionen Parametern und einem Kontextfenster von einer Million Tokens. Mit offenen Gewichten dieser Größenordnung gehört es zu den bislang größten veröffentlichten offenen Modellen.
Außerdem startete Moonshot 3D Make auf kimi.ai und in der Kimi-App. Nutzer können ein 3D-Modell im Browser ansehen und bearbeiten, zum Drucken herunterladen oder ein Video und ein Live Photo exportieren. Das ist eine Produktfunktion und keine Entwickler-API; sie zeigt, wo das Unternehmen das Modell für den direkten Einsatz geeignet hält.
Entwickler erhalten auf drei Wegen Zugang zu Kimi K3.1 Pro: über eine offizielle Mitgliedschaft, die Kimi-API und Gateway-Pläne, die Kimi, DeepSeek und GLM unter einem Schlüssel bündeln. Jeder Weg hat eigene Modell-IDs, Punktemultiplikatoren und Kontextlimits; sie sind nicht austauschbar. Unser Kimi Subscription-Leitfaden vergleicht alle drei und erklärt jeweils die Einrichtung von Claude Code.
Wie gut ist das Modell beim Programmieren und bei Agentenaufgaben?
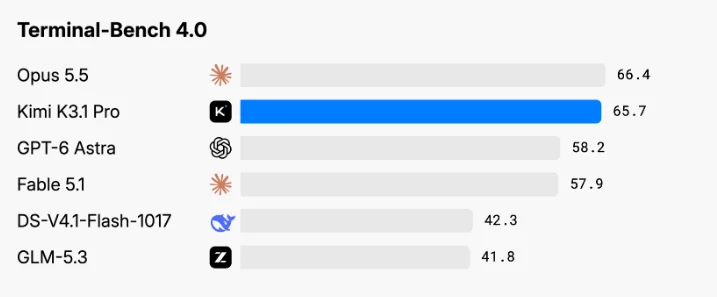
Terminal-Bench 4.0 misst vollständige Aufgaben in einer Shell statt nur der Vervollständigung einzelner Dateien. Für Kimi K3.1 Pro werden 65,7 % angegeben.
| Modell | Terminal-Bench 4.0 |
|---|---|
| Claude Opus 5.5 | 66.4% |
| Kimi K3.1 Pro | 65.7% |
| GPT-6 Astra | 58.2% |
Der Abstand von 0,7 Punkten zu Opus 5.5 ist gering; Unterschiede im Testaufbau können den Vergleich beeinflussen. Den angegebenen Vorsprung von 7,5 Punkten gegenüber GPT-6 Astra sollten Teams anhand ihrer eigenen Aufgaben und Bereitstellungskosten prüfen.
Was zeigt die Demo des laufenden Roboters?
Moonshot stellte eine schwierigere Aufgabe als einen Programmierbenchmark: einen humanoiden Laufsimulator von Grund auf zu bauen, mit 296 Skelett- und 402 Muskelkomponenten. Die erste Version fällt nach zwei Schritten um.
Kimi K3.1 Pro untersuchte die Ergebnisse, korrigierte den Regler und brachte den simulierten Körper dazu, 11,2 Sekunden lang abwechselnd die Füße zu bewegen. Als sich die Armbewegung nicht verbesserte, untersuchte es die Simulatordynamik, fand 36 Fehler bei der Berechnung der Hebelarme der Schultermuskeln, korrigierte sie und trainierte erneut.
Das geht über das Schreiben eines Patches hinaus: Das Modell untersuchte die Umgebung, in der es bewertet wurde. Ein Diagramm zeigt dieses Verhalten nur schwer.
Kann es brauchbare 3D-Modelle erzeugen?
Aus einer Textbeschreibung, Skizze oder einem Referenzbild leitet es Form, Proportionen und räumliche Beziehungen ab und erzeugt ein Modell. Eine Demo zeigt eine im Browser laufende, direkt programmierte Roboterarm-Seite mit 2.300 Teilen und fast 300 animierten Rohren.
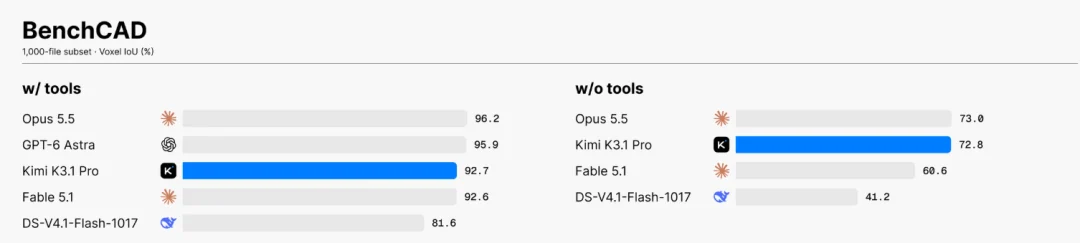
Über selbst geschriebene Skripte bedient es auch Blender und CAD-Werkzeuge. Damit sind parametrische Arbeiten wie Maschinenteile, Bauteile und maßgefertigte Möbel möglich. Bei BenchCAD erreicht es mit Werkzeugen 92,7 gegenüber 96,2 für Claude Opus 5.5 und 95,9 für GPT-6 Astra.
Die 92,7 gelten für den Einsatz von Werkzeugen; der Vergleich enthält auch eine Spalte ohne Werkzeuge. Das Ergebnis misst Modell und Arbeitsablauf. Ein Skript-Runner allein garantiert kein vergleichbares Resultat: Aufgabe, Werkzeuge, Prompts und Testaufbau sind ebenfalls entscheidend.
Sind die Ergebnisse bei Finanzaufgaben verlässlich genug?
Moonshot beschreibt einen vollständigen Ablauf: Dokumentensuche, Abgleich zwischen Dokumenten, Modellaufbau und Rentabilitätsanalyse. Bei OfficeQA Pro v2, das komplexe Analysen echter Finanzdokumente prüft, erreicht das Modell 64,4; beim Start wurde dies als bestes Ergebnis angegeben.
Eine Demo erstellt ein NVIDIA-Finanzmodell von Anfang bis Ende mit verknüpften Formeln, dokumentierten Annahmen, je Szenario anpassbaren operativen Treibern und einer Sensitivitätstabelle für die Bewertung.
Im internen Kimi Hallu Bench Hard sinkt die Halluzinationsrate pro Aussage von 23,4 % bei K3 auf 8,3 % bei K3.1 Pro. Der Anteil der Antworten mit mindestens einem Faktenfehler beträgt 42,4 % des Werts der Vorgängergeneration.
8,3 % sind ein Fortschritt, aber für eine ungeprüfte Veröffentlichung zu hoch. Rund eine falsche Aussage von zwölf mag für einen ersten Entwurf hinnehmbar sein, nicht aber für ein Dokument, das ein Kunde unterschreibt.
Was sollte man vor einem Wechsel prüfen?
Vier Punkte, die häufig zuerst relevant werden:
- Gesamtgröße: 2,8 Billionen Parameter sprechen für den Betrieb im Rechenzentrum. Auch bei sparsamer Aktivierung erfordert Selbsthosting erhebliche GPU-Mittel und ein Betriebsteam. Für die meisten ist ein gehosteter Dienst praktischer.
- Kontextkosten: Eine Million Tokens ist für große Repositorys nützlich, doch bei langen Sitzungen wird die Eingabe bei jedem Schritt erneut berechnet. Den gesamten Code im Kontext zu halten, kann mehr kosten als gezieltes Abrufen.
- Benchmark-Quelle: Die Zahlen stammen aus Moonshots Veröffentlichung und wurden für diesen Artikel nicht unabhängig reproduziert. Anbieter-Tests können günstige Bedingungen widerspiegeln.
- Werkzeugabhängigkeit: BenchCAD und die Finanzabläufe setzen Codeausführung voraus. Vor einem Vergleich prüfen, ob die eigene Umgebung eine isolierte Ausführung bietet.
Die Veröffentlichung beantwortet auch die Frage nach der Latenz bei hoher Last nicht. Ein Modell kann pro Token günstig und für interaktive Agenten dennoch zu langsam sein. Das muss beim Anbieter geprüft werden.
Häufige Fragen
Sind die Gewichte von Kimi K3.1 Pro offen?
Ja. Moonshot veröffentlichte die Gewichte auf Hugging Face unter der Kimi K3.1 Pro License. Die Modellkarte nennt 2,8 Billionen Parameter und eine Million Tokens Kontext. Vor der Nutzung sollte die Lizenz geprüft werden; offene Gewichte bedeuten nicht automatisch eine uneingeschränkte Open-Source-Lizenz.
Wie schneidet es gegenüber Claude Opus 5.5 ab?
Bei Terminal-Bench 4.0 erzielt es 65,7 % gegenüber 66,4 % für Opus 5.5; bei BenchCAD mit Werkzeugen 92,7 gegenüber 96,2. Beide Zahlen stammen von Moonshot und sind als Orientierung zu verstehen.
Lässt es sich auf einem einzelnen Server betreiben?
Das vollständige Modell benötigt viel Speicher und Rechenleistung. Quantisierung, Auslagerung und spezialisierte Hardware können die Anforderungen verändern; Latenz und Durchsatz müssen für die eigene Konfiguration getestet werden. Viele Teams werden einen gehosteten Dienst bevorzugen.