Atualizado em 5 de novembro de 2026
Moonshot libera os pesos do Kimi K3.1 Pro: o que muda para desenvolvedores?
Por Cameron Voss
ResumoA Moonshot liberou os pesos do Kimi K3.1 Pro, um modelo de mistura de especialistas com 2,8 trilhões de parâmetros e janela de contexto de 1 milhão de tokens. Ele marca 65,7% no Terminal-Bench 4.0, contra 66,4% do Claude Opus 5.5 e 58,2% do GPT-6 Astra. Com ferramentas, obtém 92,7 no BenchCAD (Opus 5.5: 96,2) e 64,4 no OfficeQA Pro v2. A taxa de alucinação por afirmação cai de 23,4% no K3 para 8,3%. Pesos abertos não tornam a inferência barata: nessa escala, a maioria das equipes ainda recorrerá a serviços hospedados.
Os pesos estão no Hugging Face, em moonshotai/Kimi-K3.1-Pro. A conta NVIDIA AI parabenizou a equipe naquela manhã, e alguns desenvolvedores descreveram o lançamento como um modelo da classe Fable que agora pode ser baixado.
Para quem programa ou coloca agentes em produção, as perguntas são mais específicas: em quais condições os números se sustentam e o que acontece ao integrar o modelo a um fluxo real?
O que a Moonshot lançou?
Um modelo de mistura de especialistas com 2,8 trilhões de parâmetros e janela de contexto de 1 milhão de tokens. Com pesos abertos nessa escala, ele está entre os maiores modelos abertos lançados até agora.
A Moonshot também lançou o 3D Make no kimi.ai e no aplicativo Kimi. É possível visualizar e editar um modelo 3D no navegador, baixá-lo para impressão ou exportar vídeo e Live Photo. É um recurso do produto, não uma API para desenvolvedores, e mostra onde a empresa considera o modelo pronto para uso direto.
O Kimi K3.1 Pro chega aos desenvolvedores por três caminhos: uma assinatura oficial, a API da Kimi e planos de gateway que reúnem Kimi, DeepSeek e GLM em uma única chave. Cada opção tem seus próprios IDs de modelo, multiplicadores de pontos e limites de contexto; elas não são intercambiáveis. Nosso guia de Kimi Subscription compara os três caminhos e mostra a configuração do Claude Code para cada um.
Como ele se sai em programação e tarefas de agentes?
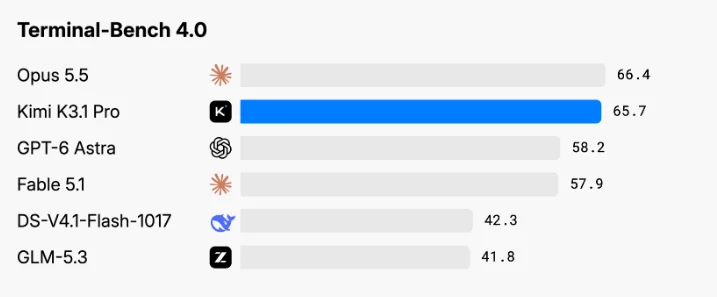
O Terminal-Bench 4.0 avalia tarefas completas em um terminal, em vez de apenas completar arquivos. O Kimi K3.1 Pro registra 65,7%.
| Modelo | Terminal-Bench 4.0 |
|---|---|
| Claude Opus 5.5 | 66.4% |
| Kimi K3.1 Pro | 65.7% |
| GPT-6 Astra | 58.2% |
A diferença de 0,7 ponto em relação ao Opus 5.5 é pequena e a configuração da avaliação pode afetar a comparação. A vantagem declarada de 7,5 pontos sobre o GPT-6 Astra merece ser testada com suas próprias tarefas e custos de implantação.
O que a demonstração do robô caminhando mostra?
A Moonshot propôs uma tarefa mais difícil que um benchmark de programação: criar do zero um simulador de caminhada humanoide com 296 componentes de esqueleto e 402 musculares. A primeira versão cai depois de dois passos.
O Kimi K3.1 Pro examinou os resultados, corrigiu o controlador e fez o corpo simulado alternar os pés por 11,2 segundos. Quando os braços não melhoraram, investigou a dinâmica do simulador, encontrou 36 erros no cálculo do braço de momento dos músculos do ombro, corrigiu-os e treinou novamente.
Essa capacidade vai além de escrever uma correção: o modelo depurou o próprio ambiente em que era avaliado, algo difícil de mostrar em um gráfico.
Ele consegue produzir modelos 3D utilizáveis?
Com uma descrição em texto, um esboço ou uma imagem de referência, infere forma, proporções e relações espaciais e gera um modelo que pode ser aberto. Uma demonstração mostra uma página de braço robótico criada em código, com 2.300 peças e quase 300 tubos animados.
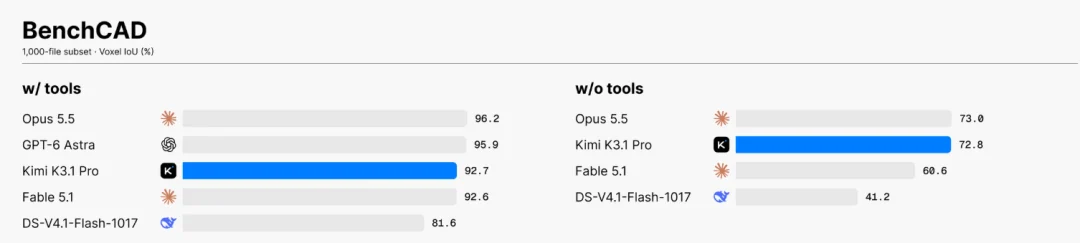
Ele também usa Blender e ferramentas CAD por meio de scripts, permitindo trabalhos paramétricos como peças mecânicas, componentes de construção e móveis sob medida. No BenchCAD, alcança 92,7 com ferramentas, contra 96,2 do Claude Opus 5.5 e 95,9 do GPT-6 Astra.
O resultado de 92,7 usa ferramentas; a comparação também tem uma coluna sem elas. A pontuação reflete o modelo e o fluxo de trabalho. Um executor de scripts, sozinho, não garante resultado semelhante: tarefa, ferramentas, prompts e avaliação também importam.
O trabalho financeiro é confiável para uso?
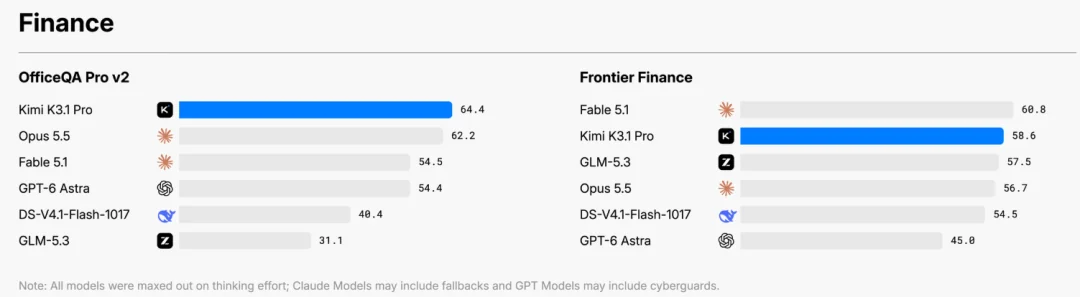
A Moonshot descreve um fluxo completo: busca de documentos, conferência entre documentos, construção de modelos e análise de rentabilidade. No OfficeQA Pro v2, que avalia análises complexas de documentos financeiros reais, o resultado é 64,4, apresentado como o melhor no lançamento.
Uma demonstração cria um modelo financeiro da NVIDIA de ponta a ponta, com fórmulas vinculadas, premissas documentadas, variáveis operacionais ajustáveis por cenário e uma tabela de sensibilidade para a avaliação.
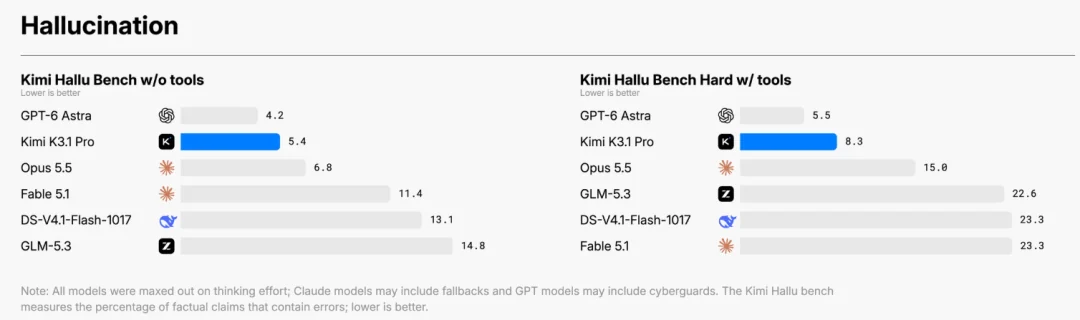
No teste interno Kimi Hallu Bench Hard, a taxa de alucinação por afirmação cai de 23,4% no K3 para 8,3% no K3.1 Pro. A proporção de respostas com ao menos um erro factual equivale a 42,4% da taxa da geração anterior.
O resultado de 8,3% é um avanço, mas ainda é alto demais para dispensar revisão. Cerca de uma afirmação errada em doze pode ser aceitável em um primeiro rascunho, mas não em um documento que um cliente assine.
O que verificar antes de trocar?
Quatro pontos que costumam pesar primeiro:
- Tamanho total. Os 2,8 trilhões de parâmetros apontam para implantação em data center. Mesmo com ativação esparsa, hospedar o modelo exige investimento relevante em GPUs e uma equipe. Para a maioria, um serviço hospedado será mais prático.
- Custo do contexto. Um milhão de tokens ajuda em agentes que lidam com repositórios, mas sessões longas cobram novamente a entrada a cada turno. Manter todo o repositório no contexto pode custar mais que recuperar apenas o necessário.
- Origem dos benchmarks. As pontuações vêm do material de lançamento da Moonshot, sem reprodução independente para este artigo. Testes do fornecedor podem refletir condições favoráveis.
- Dependência de ferramentas. O BenchCAD e os fluxos financeiros pressupõem execução de código. Confira se seu ambiente oferece isolamento antes de comparar os resultados.
O anúncio também não responde à questão da latência em escala. Um modelo pode ser barato por token e ainda ser lento para um agente interativo. É preciso verificar com o provedor.
Perguntas frequentes
Os pesos do Kimi K3.1 Pro são abertos?
Sim. A Moonshot publicou os pesos no Hugging Face sob a licença Kimi K3.1 Pro. A ficha descreve um modelo de mistura de especialistas com 2,8 trilhões de parâmetros e contexto de 1 milhão de tokens. Leia a licença antes de usar: pesos abertos não significam necessariamente uma licença de código aberto sem restrições.
Como ele se compara ao Claude Opus 5.5?
No Terminal-Bench 4.0, marca 65,7% contra 66,4% do Opus 5.5; no BenchCAD com ferramentas, 92,7 contra 96,2. São números divulgados pela Moonshot e devem ser vistos como indicativos.
Ele pode rodar em um único servidor?
O modelo completo exige muita memória e processamento. Quantização, descarregamento de partes do modelo e hardware especializado podem alterar os requisitos, mas latência e desempenho precisam ser testados em cada configuração. Muitas equipes preferirão um serviço hospedado.