Actualizado el 5 de noviembre de 2026
Moonshot publica los pesos de Kimi K3.1 Pro: ¿qué significa para los desarrolladores?
Por Cameron Voss
ResumenMoonshot publicó los pesos de Kimi K3.1 Pro, un modelo de mezcla de expertos con 2,8 billones de parámetros y una ventana de contexto de 1 millón de tokens. Obtiene un 65,7 % en Terminal-Bench 4.0, frente al 66,4 % de Claude Opus 5.5 y el 58,2 % de GPT-6 Astra. Con herramientas alcanza 92,7 en BenchCAD (Opus 5.5: 96,2) y 64,4 en OfficeQA Pro v2. La tasa de alucinaciones por afirmación baja del 23,4 % en K3 al 8,3 %. Los pesos abiertos no hacen barata la inferencia: a esta escala, la mayoría de los equipos seguirá recurriendo a servicios alojados.
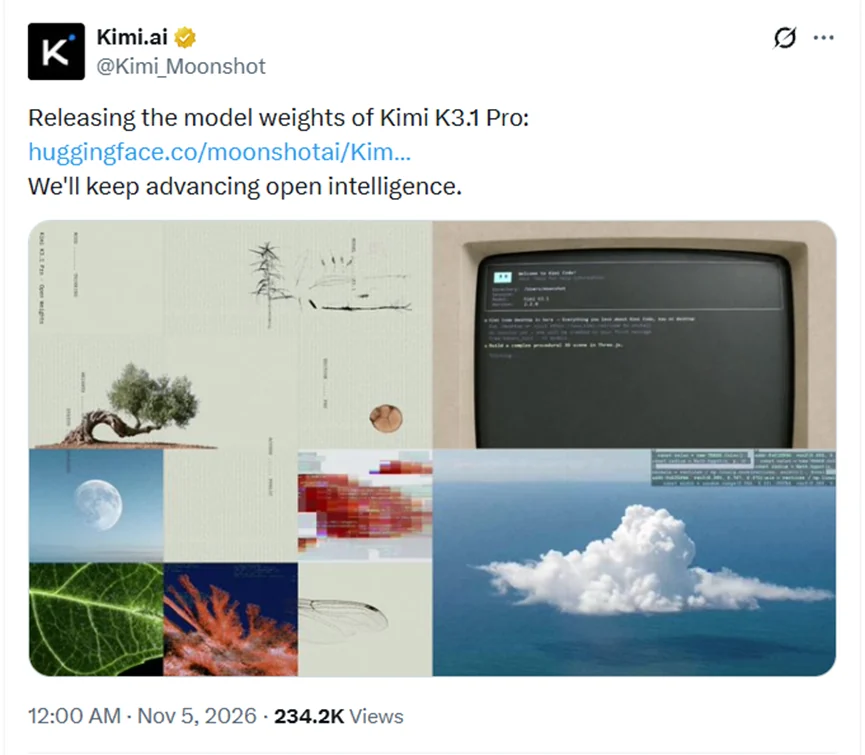
Los pesos están publicados en Hugging Face bajo moonshotai/Kimi-K3.1-Pro. La cuenta de NVIDIA AI felicitó al equipo esa misma mañana y algunos desarrolladores describieron el lanzamiento como un modelo de la clase Fable que ahora pueden descargar.
Para quienes programan o implementan flujos de agentes, las preguntas son más concretas: ¿en qué condiciones se sostienen las cifras y qué ocurre al integrar el modelo en un sistema real?
¿Qué publicó exactamente Moonshot?
Un modelo de mezcla de expertos con 2,8 billones de parámetros y una ventana de contexto de 1 millón de tokens. Sus pesos abiertos lo sitúan entre los modelos abiertos más grandes publicados hasta ahora.
Moonshot también lanzó 3D Make en kimi.ai y en la aplicación Kimi. Permite previsualizar y editar un modelo 3D en el navegador, descargarlo para imprimir o exportar un vídeo y una Live Photo. Es una función de producto, no una API para desarrolladores, y muestra dónde la empresa considera que el modelo está listo para el uso directo.
Kimi K3.1 Pro llega a los desarrolladores por tres vías: una membresía oficial, la API de Kimi y planes de pasarela que reúnen Kimi, DeepSeek y GLM bajo una sola clave. Cada vía tiene identificadores de modelo, multiplicadores de puntos y límites de contexto propios; no son intercambiables. Nuestra guía de Kimi Subscription compara las tres y explica la configuración de Claude Code para cada una.
¿Qué tal funciona en programación y tareas de agentes?
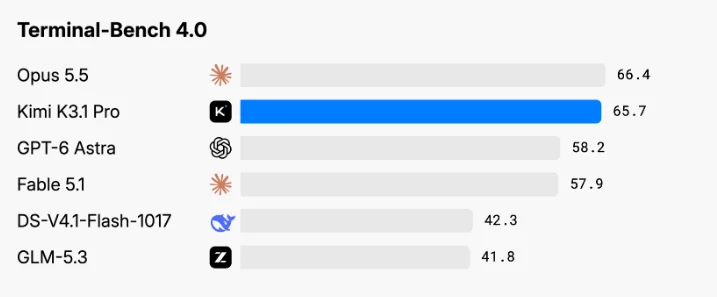
Terminal-Bench 4.0 evalúa tareas completas en una terminal, no solo la finalización de archivos. Kimi K3.1 Pro registra un 65,7 %.
| Modelo | Terminal-Bench 4.0 |
|---|---|
| Claude Opus 5.5 | 66.4% |
| Kimi K3.1 Pro | 65.7% |
| GPT-6 Astra | 58.2% |
La diferencia de 0,7 puntos con Opus 5.5 es pequeña y la configuración de evaluación puede afectar a la comparación. La ventaja declarada de 7,5 puntos sobre GPT-6 Astra merece comprobarse con tus propias tareas y costes de despliegue.
¿Qué demuestra la prueba del robot caminante?
Moonshot planteó una tarea más compleja que un benchmark de programación: construir desde cero un simulador de marcha humanoide con 296 componentes óseos y 402 musculares. La primera versión cae tras dos pasos.
Kimi K3.1 Pro examinó sus resultados, corrigió el controlador y logró que el cuerpo simulado alternara los pies durante 11,2 segundos. Cuando el movimiento de los brazos no mejoró, investigó la dinámica del simulador, encontró 36 errores en el cálculo del brazo de momento de los músculos del hombro, los corrigió y volvió a entrenar.
Es una capacidad distinta de escribir un parche: el modelo depuró el entorno en el que se evaluaba, un comportamiento difícil de apreciar en una gráfica.
¿Puede producir modelos 3D utilizables?
A partir de texto, un boceto o una imagen de referencia, infiere formas, proporciones y relaciones espaciales y genera un modelo que se puede abrir. Una demostración muestra una página web de un brazo robótico, creada con código, con 2.300 piezas y casi 300 tubos animados.
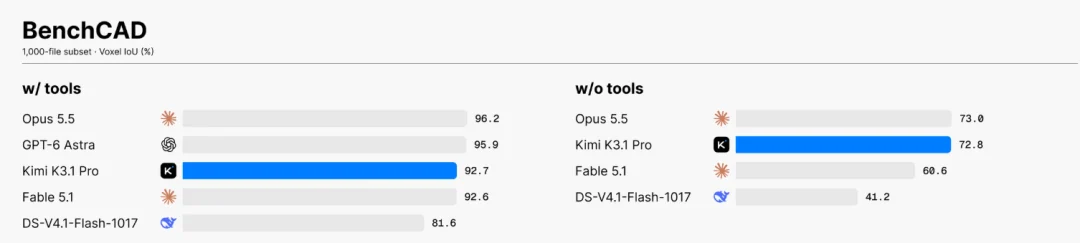
También controla Blender y herramientas CAD mediante scripts, lo que permite trabajos paramétricos como piezas mecánicas, elementos de construcción y muebles a medida. En BenchCAD obtiene 92,7 con herramientas, frente a 96,2 de Claude Opus 5.5 y 95,9 de GPT-6 Astra.
El 92,7 corresponde al uso de herramientas; la comparación publicada también incluye una columna sin ellas. La puntuación refleja el modelo y el flujo de trabajo. Contar con un ejecutor de scripts no garantiza un resultado similar: importan la tarea, las herramientas, los prompts y la evaluación.
¿Son suficientemente fiables sus resultados financieros?
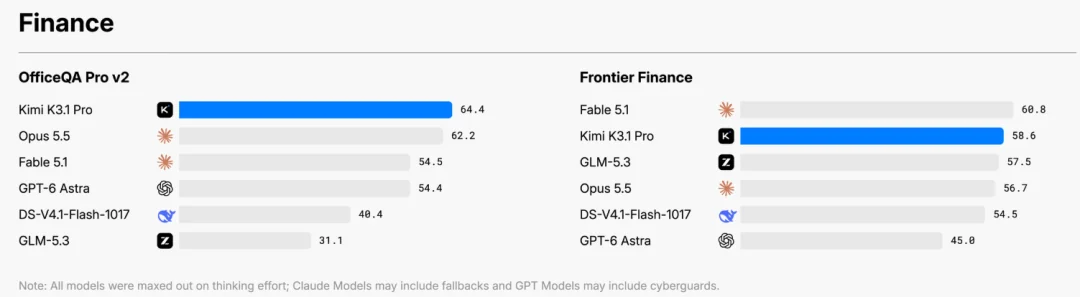
Moonshot describe un flujo completo: búsqueda documental, comprobaciones entre documentos, construcción de modelos y análisis de rentabilidad. En OfficeQA Pro v2, que evalúa análisis complejos de documentos financieros reales, obtiene 64,4, presentado como el mejor resultado en el momento del lanzamiento.
Una demostración construye de principio a fin un modelo financiero de NVIDIA con fórmulas enlazadas, supuestos escritos, variables operativas ajustables por escenario y una tabla de sensibilidad para la valoración.
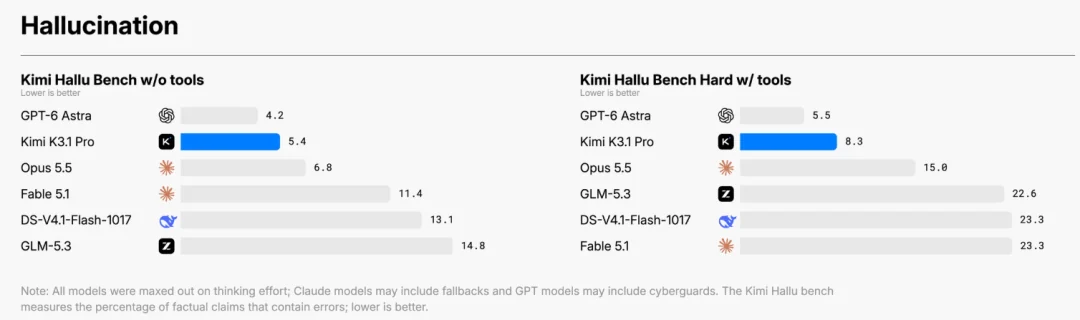
En la prueba interna Kimi Hallu Bench Hard, la tasa de alucinaciones por afirmación baja del 23,4 % en K3 al 8,3 % en K3.1 Pro. La proporción de respuestas con al menos un error factual equivale al 42,4 % de la cifra de la generación anterior.
El 8,3 % es un avance, pero sigue siendo demasiado alto para publicar sin revisión. Aproximadamente una afirmación errónea de cada doce puede ser aceptable en un borrador inicial, pero no en un documento que firme un cliente.
¿Qué conviene comprobar antes de cambiar?
Cuatro aspectos que suelen afectar primero:
- Tamaño total. Los 2,8 billones de parámetros apuntan a una implementación de centro de datos. Incluso con activación dispersa, alojarlo exige una inversión considerable en GPU y personal. Para la mayoría será más práctico usar un proveedor.
- Coste del contexto. Un millón de tokens ayuda con repositorios grandes, pero las sesiones largas vuelven a facturar la entrada en cada turno. Mantener todo el repositorio en contexto puede costar más que recuperar solo lo necesario.
- Origen de los benchmarks. Las cifras proceden del material de lanzamiento de Moonshot, no de una evaluación independiente para este artículo. Las pruebas del proveedor pueden reflejar condiciones favorables.
- Dependencia de herramientas. BenchCAD y los flujos financieros presuponen que el modelo ejecuta código. Comprueba que tu entorno ofrece un entorno aislado antes de comparar resultados.
El anuncio tampoco resuelve la latencia a escala. Un modelo puede ser barato por token y seguir siendo lento para un agente interactivo. Hay que comprobarlo con el proveedor.
Preguntas frecuentes
¿Son abiertos los pesos de Kimi K3.1 Pro?
Sí. Moonshot publicó los pesos en Hugging Face bajo la licencia Kimi K3.1 Pro. La ficha describe un modelo de mezcla de expertos con 2,8 billones de parámetros y contexto de 1 millón de tokens. Revisa la licencia antes de usarlo: pesos abiertos no implica necesariamente una licencia de código abierto sin restricciones.
¿Cómo se compara con Claude Opus 5.5?
En Terminal-Bench 4.0 obtiene un 65,7 % frente al 66,4 % de Opus 5.5; en BenchCAD con herramientas, 92,7 frente a 96,2. Son cifras comunicadas por Moonshot y conviene tratarlas como orientativas.
¿Puede ejecutarse en un solo servidor?
El modelo completo requiere mucha memoria y capacidad de cálculo. La cuantización, la descarga de partes del modelo y el hardware especializado pueden modificar los requisitos, pero hay que probar latencia y rendimiento en cada configuración. Muchos equipos preferirán un servicio alojado.