Mis à jour le 5 novembre 2026
Moonshot publie les poids de Kimi K3.1 Pro : quelles conséquences pour les développeurs ?
Par Cameron Voss
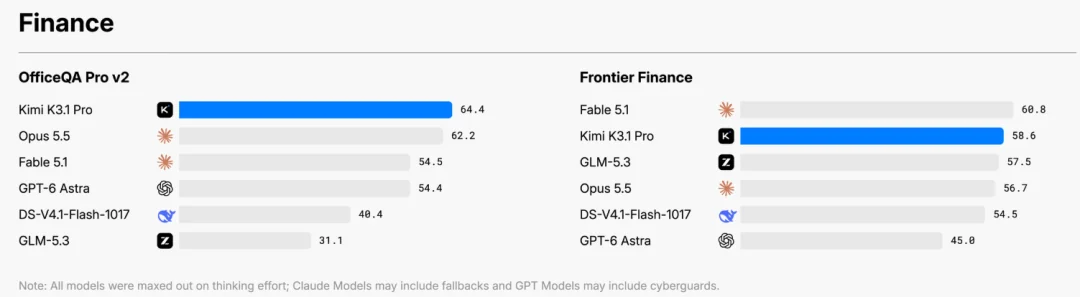
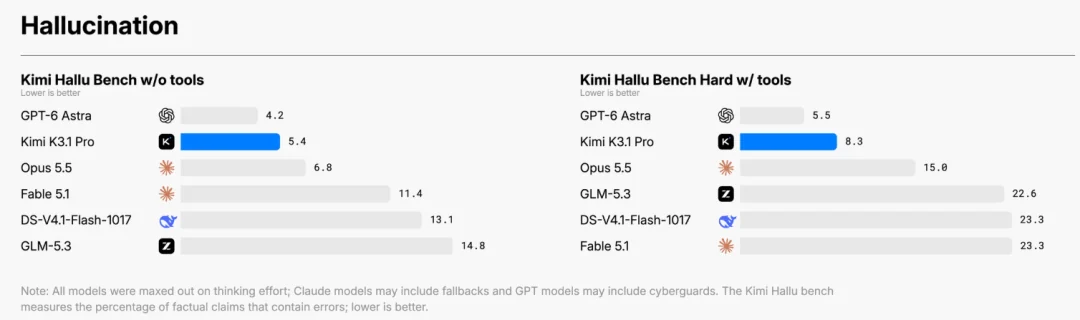
En brefMoonshot a publié les poids de Kimi K3.1 Pro, un modèle à mélange d’experts de 2 800 milliards de paramètres doté d’une fenêtre de contexte d’un million de tokens. Il obtient 65,7 % sur Terminal-Bench 4.0, contre 66,4 % pour Claude Opus 5.5 et 58,2 % pour GPT-6 Astra. Avec des outils, il atteint 92,7 sur BenchCAD (Opus 5.5 : 96,2) et 64,4 sur OfficeQA Pro v2. Le taux d’hallucination par affirmation passe de 23,4 % pour K3 à 8,3 %. Des poids ouverts ne rendent pas l’inférence bon marché : à cette échelle, la plupart des équipes utiliseront un service hébergé.
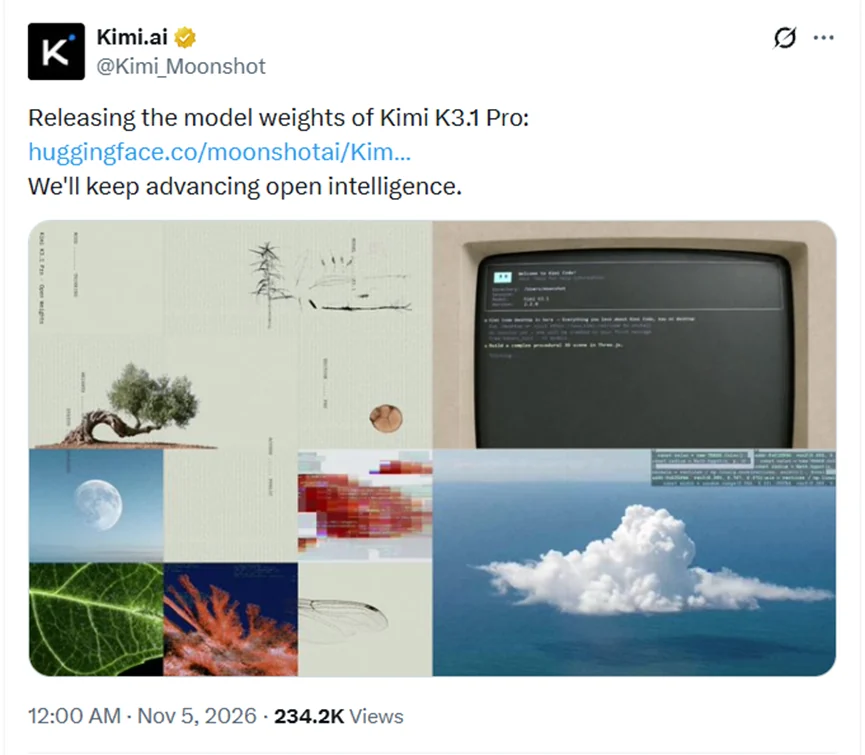
Les poids sont disponibles sur Hugging Face sous moonshotai/Kimi-K3.1-Pro. Le compte NVIDIA AI a félicité l’équipe le même matin et certains développeurs ont décrit la publication comme un modèle de la classe Fable désormais téléchargeable.
Pour les développeurs et les équipes qui déploient des agents, les questions sont plus précises : dans quelles conditions les chiffres tiennent-ils et que se passe-t-il dans un flux de travail réel ?
Qu’a publié Moonshot exactement ?
Un modèle à mélange d’experts de 2 800 milliards de paramètres, avec une fenêtre de contexte d’un million de tokens. À cette échelle, ses poids ouverts le placent parmi les plus grands modèles ouverts publiés à ce jour.
Moonshot a aussi lancé 3D Make sur kimi.ai et dans l’application Kimi. On peut visualiser et modifier un modèle 3D dans le navigateur, le télécharger pour l’imprimer ou exporter une vidéo et une Live Photo. Il s’agit d’une fonction du produit, non d’une API développeur ; elle montre les usages que l’entreprise estime prêts à être proposés directement.
Les développeurs peuvent accéder à Kimi K3.1 Pro de trois façons : une adhésion officielle, l’API Kimi et des offres de passerelle réunissant Kimi, DeepSeek et GLM derrière une seule clé. Chaque solution a ses propres identifiants de modèles, multiplicateurs de points et limites de contexte ; elles ne sont pas interchangeables. Notre guide Kimi Subscription compare les trois et explique la configuration de Claude Code pour chacune.
Que vaut-il pour le code et les agents ?
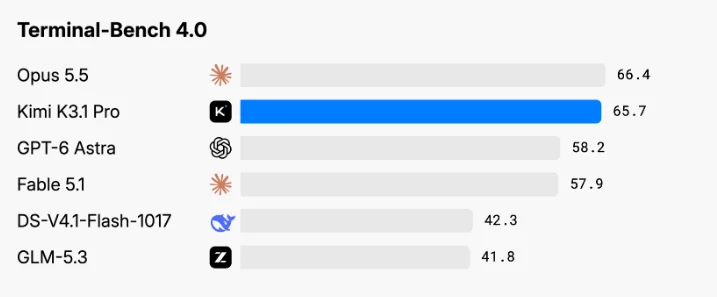
Terminal-Bench 4.0 mesure des tâches complètes dans un terminal plutôt que la simple complétion de fichiers. Kimi K3.1 Pro affiche 65,7 %.
| Modèle | Terminal-Bench 4.0 |
|---|---|
| Claude Opus 5.5 | 66.4% |
| Kimi K3.1 Pro | 65.7% |
| GPT-6 Astra | 58.2% |
L’écart de 0,7 point avec Opus 5.5 est faible et les conditions d’évaluation peuvent influencer la comparaison. L’avance annoncée de 7,5 points sur GPT-6 Astra mérite d’être vérifiée sur vos propres tâches et coûts de déploiement.
Que montre la démonstration du robot qui marche ?
Moonshot a proposé une tâche plus difficile qu’un benchmark de code : construire de zéro un simulateur de marche humanoïde comprenant 296 composants squelettiques et 402 composants musculaires. La première version tombe après deux pas.
Kimi K3.1 Pro a examiné ses résultats, corrigé le contrôleur et permis au corps simulé d’alterner les pieds pendant 11,2 secondes. Lorsque le mouvement des bras ne s’améliorait pas, il a examiné la dynamique du simulateur, trouvé 36 erreurs dans le calcul des bras de levier des muscles de l’épaule, les a corrigées puis a relancé l’entraînement.
Cette capacité dépasse l’écriture d’un correctif : le modèle a débogué l’environnement dans lequel il était évalué, un comportement difficile à saisir dans un graphique.
Peut-il produire des modèles 3D utilisables ?
À partir d’un texte, d’une esquisse ou d’une image de référence, il déduit la forme, les proportions et les relations spatiales, puis produit un modèle ouvrable. Une démonstration présente une page de bras robotique codée pour le navigateur, avec 2 300 pièces et près de 300 tuyaux animés.
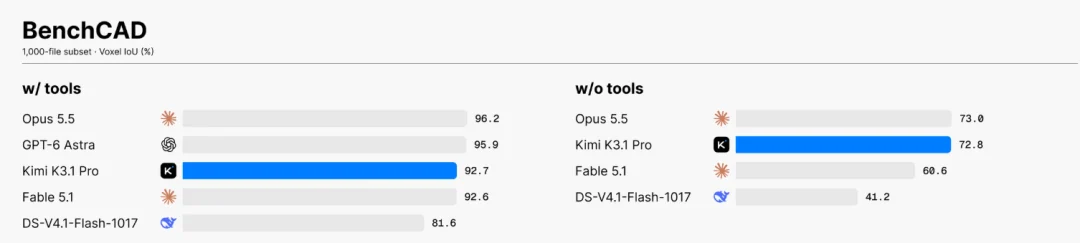
Il pilote aussi Blender et des outils de CAO en écrivant et exécutant des scripts, pour des travaux paramétriques tels que pièces mécaniques, éléments de construction et meubles sur mesure. Sur BenchCAD, il obtient 92,7 avec outils, contre 96,2 pour Claude Opus 5.5 et 95,9 pour GPT-6 Astra.
Le score de 92,7 utilise des outils ; la comparaison publiée comporte aussi une colonne sans outils. Le score reflète le modèle et son flux de travail. Un simple exécuteur de scripts ne garantit pas un résultat comparable : la tâche, les outils, les instructions et l’évaluation comptent aussi.
Les résultats financiers sont-ils assez fiables pour être utilisés ?
Moonshot décrit un flux complet : recherche de documents, vérifications croisées, construction de modèles et analyse de rentabilité. Sur OfficeQA Pro v2, qui teste des analyses complexes de documents financiers réels, le score est de 64,4, présenté comme le meilleur au lancement.
Une démonstration construit un modèle financier NVIDIA de bout en bout, avec formules liées, hypothèses documentées, variables opérationnelles ajustables selon le scénario et tableau de sensibilité pour la valorisation.
Sur le test interne Kimi Hallu Bench Hard, le taux d’hallucination par affirmation passe de 23,4 % pour K3 à 8,3 % pour K3.1 Pro. La proportion de réponses contenant au moins une erreur factuelle représente 42,4 % de celle de la génération précédente.
Le taux de 8,3 % marque un progrès, mais reste trop élevé pour se passer de vérification. Environ une affirmation erronée sur douze peut convenir à un premier brouillon, pas à un document signé par un client.
Que vérifier avant de changer de modèle ?
Quatre points qui posent souvent problème en premier :
- Taille totale. Les 2 800 milliards de paramètres correspondent à un déploiement en centre de données. Même avec une activation parcimonieuse, l’hébergement exige un budget GPU conséquent et une équipe. Un service hébergé sera plus pratique pour la plupart des utilisateurs.
- Coût du contexte. Un million de tokens est utile pour les agents travaillant sur des dépôts, mais les longues sessions refacturent l’entrée à chaque tour. Conserver tout le dépôt dans le contexte peut coûter plus cher que récupérer les éléments nécessaires.
- Origine des benchmarks. Les scores proviennent des documents de lancement de Moonshot et n’ont pas été reproduits indépendamment pour cet article. Les tests du fournisseur peuvent refléter des conditions favorables.
- Dépendance aux outils. BenchCAD et les flux financiers supposent que le modèle peut exécuter du code. Vérifiez que votre environnement permet une exécution isolée avant de comparer les scores.
L’annonce ne répond pas non plus à la question de la latence à grande échelle. Un modèle peut être peu coûteux par token tout en étant trop lent pour un agent interactif. Il faut le vérifier auprès du fournisseur.
Questions fréquentes
Les poids de Kimi K3.1 Pro sont-ils ouverts ?
Oui. Moonshot a publié les poids sur Hugging Face sous la licence Kimi K3.1 Pro. La fiche décrit un modèle à mélange d’experts de 2 800 milliards de paramètres et un contexte d’un million de tokens. Consultez la licence avant utilisation : des poids ouverts ne signifient pas nécessairement une licence open source sans restriction.
Comment se compare-t-il à Claude Opus 5.5 ?
Sur Terminal-Bench 4.0, il obtient 65,7 % contre 66,4 % pour Opus 5.5 ; sur BenchCAD avec outils, 92,7 contre 96,2. Ces deux chiffres sont communiqués par Moonshot et doivent être considérés comme indicatifs.
Peut-il fonctionner sur un seul serveur ?
Le modèle complet exige beaucoup de mémoire et de puissance de calcul. La quantification, le déchargement d’une partie du modèle et du matériel spécialisé peuvent modifier les besoins ; la latence et le débit doivent être testés dans votre configuration. De nombreuses équipes préféreront un service hébergé.