19 de noviembre de 2026
Gemini 4 Neon lidera la clasificación de agentes de programación con el entorno de Google
Por Cameron Voss
Qué es Gemini 4 Neon
Neon es el cuarto integrante de la familia Gemini 4 y el que Google sitúa por debajo del Carbon en precio. Demis Hassabis lo anunció y lo llamó el pináculo de la alquimia. Google apunta a trabajos de ingeniería de alta frecuencia, análisis de conocimiento y tareas de investigación que toman horas en lugar de segundos.
Ese marco es más limitado que el del "mejor modelo disponible". Google vende Neon como algo que se puede ejecutar muchas veces al día sin que la factura se convierta en la historia, y la lista de precios se deriva de eso.
| Modelo | Gemini 4 Neon |
| Aporte | $3 por millón de tokens |
| Producción | $15 por millón de tokens |
| Entrada en caché | 0,15 dólares por millón de tokens |
| ventana contextual | 1.000.000 fichas |
| Velocidad de salida | Alrededor de 110 tokens por segundo |
| índice de inteligencia AA | 61 (xalto), 60 (alto) |
| Puntuación del agente de codificación AA | 58,6, primer lugar |
Cómo se compara con Opus 5.5 y GPT-6.2 Sol
Google ejecutó 19 grupos de referencia contra Claude Opus 5.5 y GPT-6.2 Sol. Neon obtuvo la máxima puntuación en 16 de ellos. El número más citado es el índice de inteligencia de Artificial Analysis: 61 en xhigh, que ocupa el tercer lugar a nivel mundial y un punto por encima de Carbon. En la configuración alta predeterminada, cae a 60, al nivel de Carbon, mientras que una tarea cuesta menos de la mitad.
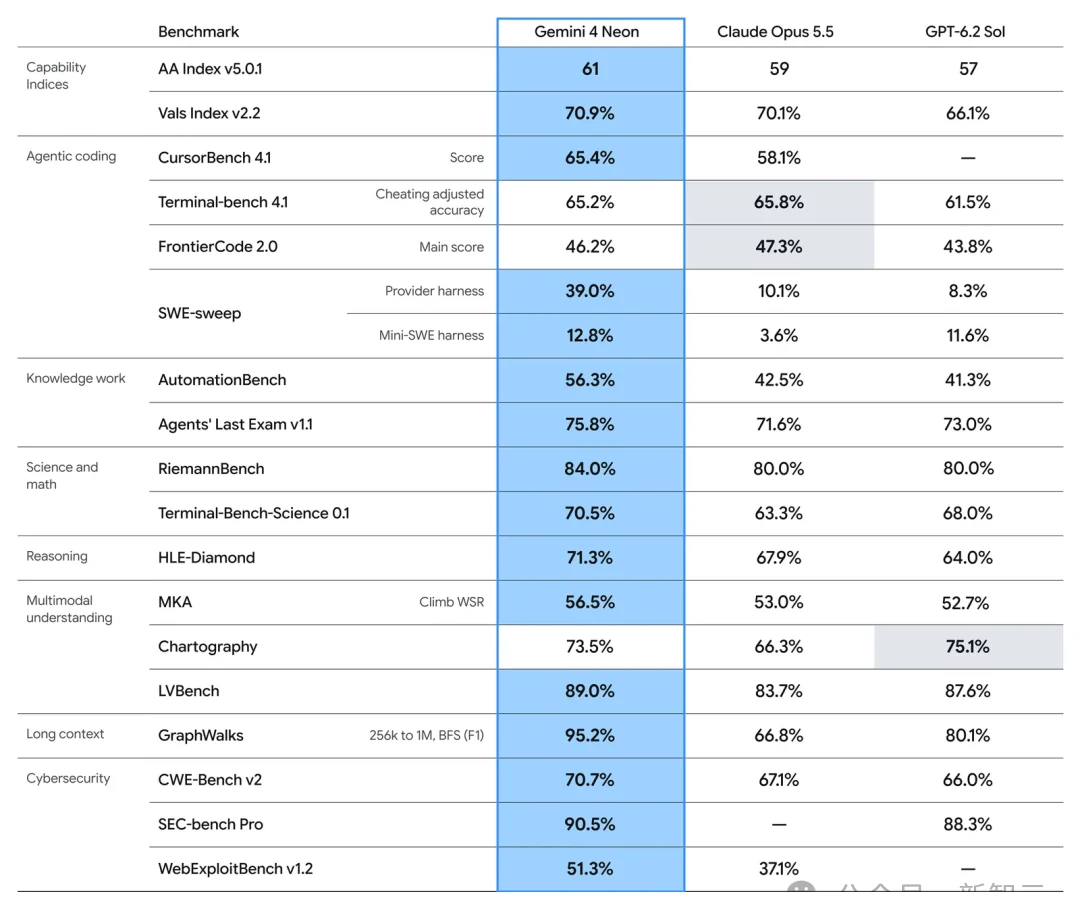
Otras tablas de clasificación aterrizan en el mismo lugar. La nueva tabla de clasificación de agentes de Arena, creada a partir de más de 4200 sesiones reales, colocó a Neon en segundo lugar en su primera aparición. El punto de referencia de automatización de Zapier, que ejecuta 657 flujos de trabajo empresariales reales, le otorgó el 56,3% y el primer lugar. En cuanto a seguridad, SEC-bench Pro obtuvo un 90,5%, un nuevo máximo, y CWE-bench v2 obtuvo 3,4 puntos por encima de Carbon.
La velocidad acompaña esos resultados. Artificial Analysis midió unos 110 tokens de salida por segundo, frente a los 57 de Carbon. La tarea media terminó en 21 minutos, frente a los 36 de Carbon.
¿Cuánto cuesta cada tarea?
Aquí es donde la brecha es más amplia. Las puntuaciones del agente de codificación están cercanas: Neon con 58,6, mientras que Fable 5.2 y Opus 5.5 de Claude Code rondan los 58. Las facturas no están nada cerca.
| Modelo | Puntuación del agente codificador | Costo por tarea |
|---|---|---|
| Gemini 4 Neon | 58.6 | $6.86 |
| Claude Opus 5.5 | alrededor de 58 | $12.61 |
| Fábula de Claude 5.2 | alrededor de 58 | $15.47 |
Para lograr el primer puesto, Neon utilizó Antigravity CLI de Google como entorno de ejecución. Ese detalle importa en cualquier benchmark de agentes: el entorno determina cómo se llaman las herramientas, cuándo se compacta el contexto y cómo se reintentan los errores. Si cambia, la puntuación de un mismo modelo puede variar varios puntos.
Pruebas independientes apuntan en la misma dirección. El desarrollador Pranav Reddy le dio a Neon, Opus 5.5 y Carbon la misma animación de conducción Three.js para construir. Su lectura fue que Neon venció a Opus 5.5 y se acercó a Carbon.
Qué muestran las tres demostraciones
Google publicó tres ejemplos trabajados, cada uno de los cuales apuntaba a una debilidad diferente.
Reconstrucción del estudio de Turing en 3D. Neon dirigió el equipo /swarm durante 12 horas para recrear la habitación de Alan Turing en el King's College de Cambridge, donde escribió el artículo de 1936 que estableció la informática moderna. Sacó fotografías de archivo, modeló y equipó la habitación en Blender y representó materiales e iluminación de época. La cámara avanza desde el césped fuera de la capilla, y la máquina de Turing sobre el escritorio también está allí. Lo que esta prueba está programando: docenas de subtareas, doce horas, sin desviarse del objetivo.
Medio millón de fórmulas de hojas de cálculo. Neon distribuyó 100 000 celdas en subhojas y escribió más de 500 000 fórmulas en vivo para realizar la detección de bordes de Sobel y el mapeo de profundidad 3D sin biblioteca de imágenes. Seis modos de interacción cambian la vista y al cambiar el ángulo de luz se vuelve a iluminar la imagen en tiempo real. Este prueba si el razonamiento sobrevive siendo escrito como código que debe permanecer correcto a escala.
Un simulador de esquí escrito desde cero. 10200 líneas de sombreadores WebGL2 personalizados, un motor de física de 120 Hz, seis pistas de montaña, pistas de nieve dinámicas, avalanchas de losa, audio espacial y datos de elevación reales del Mont Blanc y Chamonix. Sin activos 3D prefabricados. Aquí la prueba es ingeniería de código largo: los sombreadores, la física, el terreno y el audio deben mantenerse juntos en un solo proyecto.
Cómo se reparten el trabajo Neon y Hydrogen
En Antigravity, Neon puede trabajar solo o actuar como orquestador. Cuando llega una tarea grande, Neon la divide y asigna las partes a subagentes Hydrogen que trabajan en paralelo. Hydrogen es el modelo ligero y más rápido de la familia, a la mitad del precio de Neon.
El reparto es claro: Neon planifica, evalúa y aprueba. Hydrogen escribe código, edita archivos y ejecuta pruebas. Si el trabajo de un subagente no supera la revisión, se le devuelve con instrucciones en lugar de aceptarlo.
La reciente propuesta de superagente de DeepSeek parece similar desde la distancia, pero resuelve un problema diferente. Swarm consiste en dividir una tarea entre varios agentes. El superagente se trata de un sistema de larga duración que rastrea muchas tareas a la vez, con un enrutador que hace coincidir los mensajes con los trabajadores. Ambos separan la coordinación de la ejecución y ambos mantienen un circuito de retroalimentación. Difieren en alcance, en quién hace el razonamiento difícil y en dónde se ubica el modelo fuerte. Google sitúa a su modelo más potente en lo más alto. El diseño de DeepSeek se basa en un enrutador más liviano con trabajadores más fuertes.
Dónde sigue por detrás Neon
Dos puntos de referencia mantienen a Opus 5.5 al frente: Terminal-bench 4.1 y FrontierCode 2.0. Ambos se apoyan en el trabajo de terminales y la reparación de códigos, y la ventaja se describe como leve más que decisiva. El margen del agente codificador también es reducido, 58,6 frente a aproximadamente 58, lo que significa que un nuevo arnés o un nuevo punto de referencia pueden cambiar el orden.
Lo que se mantiene mejor es el rendimiento y el precio. Finalizar una tarea en 21 minutos por $6,86 cambia la cantidad de veces que puedes ejecutar un agente antes de que el costo se convierta en el límite.
Planes de codificación
Si está comparando el acceso de modelos para el trabajo de agente, nuestra página plan de codificación enumera los planes que tenemos actualmente en stock y lo que incluye cada uno.
Ver planes de codificación actuales
Verifique los detalles del plan con su propia carga de trabajo antes de comprar.
Qué significa para los desarrolladores
- El coste por tarea merece la misma atención que la puntuación. Cuando un agente va unos cientos de veces al día, un 45% de descuento en la factura importa más que uno o dos puntos.
- La orquestación cambia el presupuesto. Un planificador fuerte más trabajadores paralelos baratos pueden socavar un modelo fuerte que lo hace todo, siempre y cuando el paso de revisión realmente rechace el mal trabajo.
- Verifique el arnés antes de comparar números. Las puntuaciones de los agentes vienen adjuntas a la CLI y al andamiaje que las produjo.
- Mantenga un segundo modelo a mano. Neon no es el primero en todas las pruebas y su ventaja en codificación es lo suficientemente pequeña como para desaparecer con la próxima versión.