19 november 2026
Gemini 4 Neon bovenaan ranglijst voor programmeeragenten met Googles eigen omgeving
Door Cameron Voss
Wat Gemini 4 Neon is
Neon is het vierde lid van de Gemini 4-familie en degene die Google onder Carbon plaatst op prijs. Demis Hassabis kondigde het aan en noemde het het toppunt van alchemie. Google richt zich ermee op hoogfrequent technisch werk, kennisanalyse en onderzoekstaken die uren in plaats van seconden duren.
Die omlijsting is smaller dan ‘beste model beschikbaar’. Google verkoopt Neon als iets dat je vele malen per dag kunt gebruiken zonder dat de rekening het verhaal wordt, en de prijslijst volgt daaruit.
| Model | Tweeling 4 Neon |
| Invoer | $3 per miljoen tokens |
| Uitvoer | Tokens van $ 15 per miljoen |
| Gecachte invoer | $0,15 per miljoen tokens |
| Contextvenster | 1.000.000 tokens |
| Uitvoersnelheid | Ongeveer 110 tokens per seconde |
| AA-intelligentie-index | 61 (xhoog), 60 (hoog) |
| AA codeermiddelscore | 58,6, eerste plaats |
Hoe het scoort tegenover Opus 5.5 en GPT-6.2 Sol
Google voerde 19 benchmarkgroepen uit tegen Claude Opus 5.5 en GPT-6.2 Sol. Neon behaalde de hoogste score in 16 daarvan. Het meest geciteerde getal is de intelligentie-index van Artificial Analysis: 61 op xhigh, wat wereldwijd de derde plaats is en één punt boven Carbon. Bij de standaard hoge instelling daalt het naar 60, niveau met Carbon, terwijl een taak minder dan de helft kost.
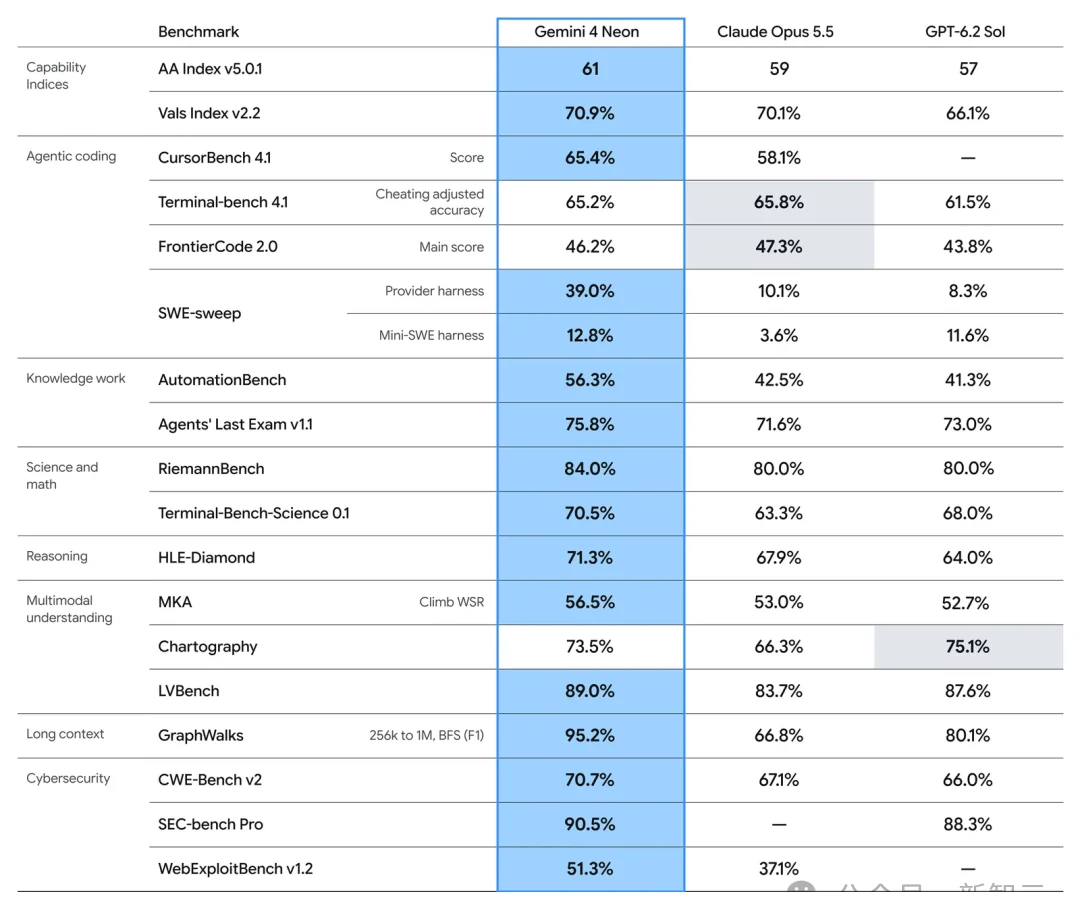
Andere klassementen landen op dezelfde plaats. Arena's nieuwe Agent-klassement, opgebouwd uit meer dan 4.200 echte sessies, plaatste Neon bij zijn eerste optreden op de tweede plaats. De automatiseringsbenchmark van Zapier, die 657 echte zakelijke workflows uitvoert, gaf het 56,3% en de eerste plaats. Op veiligheidsgebied kwam SEC-bench Pro uit op 90,5%, een nieuw hoogtepunt, en kwam CWE-bench v2 3,4 punten boven Carbon uit.
De snelheid ondersteunt dat beeld. Artificial Analysis mat ongeveer 110 outputtokens per seconde, tegenover 57 voor Carbon. Een taak duurde gemiddeld 21 minuten, tegenover 36 minuten voor Carbon.
Wat kost een taak?
Hier is de kloof het grootst. De scores van de codeeragent liggen dichtbij: Neon op 58,6, terwijl Claude Code's Fable 5.2 en Opus 5.5 beide rond de 58 zitten. De facturen komen helemaal niet overeen.
| Model | Codeermiddelscore | Kosten per taak |
|---|---|---|
| Tweeling 4 Neon | 58.6 | $6.86 |
| Claude Opus 5.5 | Ongeveer 58 | $12.61 |
| Claude-fabel 5.2 | Ongeveer 58 | $15.47 |
Voor de eerste plaats gebruikte Neon Googles eigen Antigravity CLI als uitvoeromgeving. Dat detail telt bij elke agentbenchmark: de omgeving bepaalt hoe tools worden aangeroepen, wanneer context wordt gecomprimeerd en hoe fouten opnieuw worden geprobeerd. Een andere omgeving kan de score van hetzelfde model meerdere punten verschuiven.
Onafhankelijke tests wijzen in dezelfde richting. Ontwikkelaar Pranav Reddy gaf Neon, Opus 5.5 en Carbon dezelfde Three.js-rijanimatie om te bouwen. Hij las dat Neon Opus 5.5 versloeg en dicht bij Carbon kwam.
Wat de drie demo’s laten zien
Google publiceerde drie uitgewerkte voorbeelden, die elk op een andere zwakte wezen.
De studeerkamer van Turing in 3D herbouwen. Neon leidde het /swarm-team twaalf uur lang om de kamer van Alan Turing aan King's College, Cambridge, na te bootsen, waar hij in 1936 het artikel schreef over de introductie van moderne computers. Het haalde archieffoto's op, modelleerde en richtte de kamer op in Blender, en gaf historische materialen en verlichting weer. De camera komt binnen vanaf het grasveld buiten de kapel, en de Turing-machine op het bureau staat er ook. Wat deze test inhoudt: tientallen subtaken, twaalf uur, geen afwijkingen van het doel.
Een half miljoen spreadsheetformules. Neon verspreidde 100.000 cellen over subbladen en schreef meer dan 500.000 live formules voor Sobel-randdetectie en 3D-dieptekaarten zonder beeldbibliotheek. Zes interactiemodi wisselen de weergave, en door de lichthoek te veranderen wordt het beeld in realtime opnieuw verlicht. Deze test of redenering overleeft als code wordt geschreven die op schaal correct moet blijven.
Een skisimulator die helemaal opnieuw is geschreven. 10.200 regels aangepaste WebGL2-shaders, een 120 Hz-fysica-engine, zes bergafdalingen, dynamische sneeuwsporen, plaatlawines, ruimtelijke audio en echte hoogtegegevens van de Mont Blanc en Chamonix. Geen prefab 3D-middelen. Hier is de test long-code engineering: shaders, fysica, terrein en audio moeten allemaal bij elkaar blijven in één project.
Hoe Neon en Hydrogen het werk verdelen
Binnen Antigravity kan Neon alleen werken of als orkestrator optreden. Bij een grote taak verdeelt Neon het werk over parallelle Hydrogen-subagenten. Hydrogen is het lichte en snelste model van de familie, voor de helft van de prijs van Neon.
De taakverdeling is helder: Neon plant, beoordeelt en keurt goed. Hydrogen schrijft code, bewerkt bestanden en voert tests uit. Als het werk van een subagent de beoordeling niet doorstaat, gaat het met instructies terug in plaats van te worden geaccepteerd.
Het recente Super-agent-voorstel van DeepSeek lijkt van een afstandje hetzelfde, maar lost een ander probleem op. Bij Swarm gaat het om het verdelen van één taak over meerdere agenten. Super-agent gaat over één langlopend systeem dat veel taken tegelijk bijhoudt, met een router die berichten aan werknemers koppelt. Beide scheiden de coördinatie van de uitvoering, en beide houden een feedbacklus in stand. Ze verschillen qua reikwijdte, wie de harde redenering doet en waar het sterke model zit. Google zet zijn sterkste model bovenaan. Het ontwerp van DeepSeek leunt op een lichtere router met sterkere werkers.
Waar Neon nog achterblijft
Twee benchmarks houden Opus 5.5 voorop: Terminal-bench 4.1 en FrontierCode 2.0. Beiden leunen op terminalwerk en codereparatie, en de voorsprong wordt eerder als klein dan doorslaggevend omschreven. De marge van de codeeragent is ook klein: 58,6 tegen grofweg 58, wat betekent dat een nieuw harnas of een nieuwe benchmark de volgorde kan omdraaien.
Wat beter overeind blijft, zijn de doorvoersnelheid en de prijs. Een taak in 21 minuten afronden voor $6,86 verandert hoe vaak u een agent kunt inzetten voordat de kosten de beperkende factor worden.
Coderingsplannen
Als u de toegang tot modellen voor het werk van agenten vergelijkt, vindt u op onze pagina coderingsplan de abonnementen die we momenteel op voorraad hebben en wat elk abonnement inhoudt.
Controleer de plangegevens ten opzichte van uw eigen werklast voordat u een aankoop doet.
Wat dit betekent voor ontwikkelaars
- De kosten per taak verdienen dezelfde aandacht als de score. Als een agent een paar honderd keer per dag rent, is 45% korting op de rekening meer dan één of twee punten.
- Orkestratie verandert het budget. Een sterke planner plus goedkope parallelle werkers kunnen één sterk model ondermijnen dat alles doet, zolang de evaluatiestap echt slecht werk afwijst.
- Controleer het harnas voordat u de cijfers vergelijkt. Agentscores zijn gekoppeld aan de CLI en de steigers die ze hebben geproduceerd.
- Houd een tweede model in de buurt. Neon staat niet bij elke test op de eerste plaats en de codeerlead is klein genoeg om bij de volgende release te verdwijnen.