19 de novembro de 2026
Gemini 4 Neon lidera ranking de agentes de programação no ambiente do Google
Por Cameron Voss
O que é o Gemini 4 Neon
Neon é o quarto membro da família Gemini 4 e aquele que o Google coloca abaixo do Carbon em preço. Demis Hassabis anunciou isso e chamou-o de o auge da alquimia. O Google está visando trabalhos de engenharia de alta frequência, análise de conhecimento e tarefas de pesquisa que levam horas em vez de segundos.
Esse enquadramento é mais restrito do que “melhor modelo disponível”. O Google está vendendo o Neon como algo que você pode executar muitas vezes ao dia sem que a conta vire a história, e a lista de preços segue isso.
| Modelo | Gêmeos 4 Néon |
| Entrada | US$ 3 por milhão de tokens |
| Saída | US$ 15 por milhão de tokens |
| Entrada em cache | US$ 0,15 por milhão de tokens |
| Janela de contexto | 1.000.000 fichas |
| Velocidade de saída | Cerca de 110 tokens por segundo |
| Índice de inteligência AA | 61 (xalto), 60 (alto) |
| Pontuação do agente de codificação AA | 58,6, primeiro lugar |
Como ele se compara ao Opus 5.5 e ao GPT-6.2 Sol
O Google comparou o Neon com Claude Opus 5.5 e GPT-6.2 Sol em 19 grupos de benchmarks; o Neon liderou em 16 deles. O número mais citado é o índice de inteligência da Artificial Analysis: 61 em xhigh, terceiro lugar no mundo e um ponto acima do Carbon. Na configuração padrão high, o índice cai para 60, empatado com o Carbon, enquanto o custo por tarefa é inferior à metade.
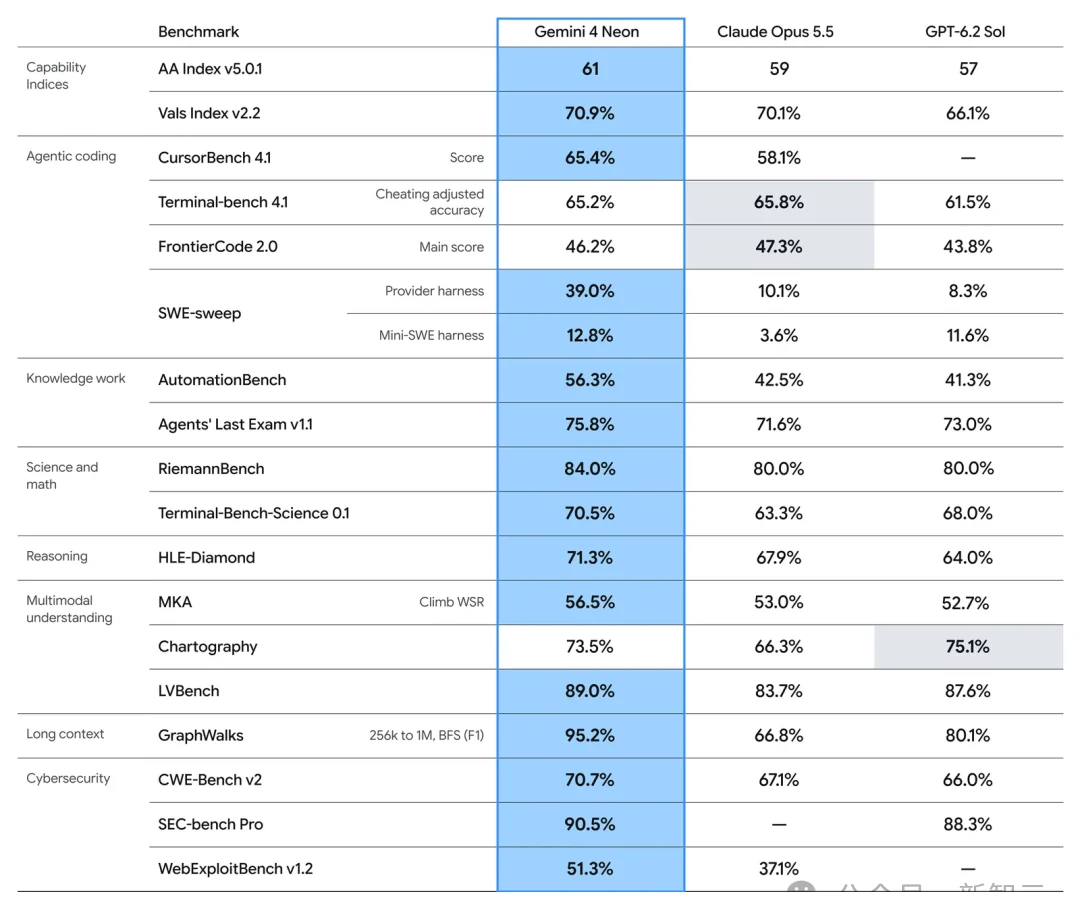
Outras tabelas de classificação chegam ao mesmo lugar. A nova tabela de classificação de agentes da Arena, construída a partir de mais de 4.200 sessões reais, colocou Neon em segundo lugar em sua primeira aparição. O benchmark de automação da Zapier, que executa 657 fluxos de trabalho de negócios reais, deu 56,3% e o primeiro lugar. Em segurança, SEC-bench Pro atingiu 90,5%, um novo recorde, e CWE-bench v2 ficou 3,4 pontos acima do Carbon.
A velocidade reforça esses resultados. A Artificial Analysis mediu cerca de 110 tokens de saída por segundo, contra 57 do Carbon. A tarefa média terminou em 21 minutos, contra 36 no Carbon.
Quanto custa por tarefa?
É aqui que a lacuna é maior. As pontuações do agente de codificação estão próximas: Neon em 58,6, com Fable 5.2 e Opus 5.5 de Claude Code, ambos em torno de 58. As faturas não estão nem um pouco próximas.
| Modelo | Pontuação do agente de codificação | Custo por tarefa |
|---|---|---|
| Gêmeos 4 Néon | 58.6 | $6.86 |
| Cláudio Opus 5.5 | Cerca de 58 | $12.61 |
| Claude Fábula 5.2 | Cerca de 58 | $15.47 |
Na execução que ficou em primeiro lugar, o Neon usou o Antigravity CLI do Google como ambiente de execução. Esse detalhe importa em qualquer benchmark de agentes: o ambiente determina como as ferramentas são chamadas, quando o contexto é compactado e como as falhas são repetidas. Mudá-lo pode alterar em vários pontos a pontuação do mesmo modelo.
Testes independentes apontam na mesma direção. O desenvolvedor Pranav Reddy deu ao Neon, Opus 5.5 e Carbon a mesma animação de pilotagem do Three.js para construir. Sua leitura foi que o Neon venceu o Opus 5.5 e chegou perto do Carbon.
O que as três demonstrações mostram
O Google publicou três exemplos práticos, cada um apontando para um ponto fraco diferente.
Reconstruindo o estudo de Turing em 3D. Neon comandou a equipe /swarm por 12 horas para recriar a sala de Alan Turing no King's College, Cambridge, onde ele escreveu o artigo de 1936 que estabeleceu a computação moderna. Ele extraiu fotografias de arquivo, modelou e equipou a sala no Blender e renderizou materiais e iluminação de época. A câmera vem do gramado do lado de fora da capela, e a máquina de Turing sobre a mesa também está lá. O que isso testa é o agendamento: dezenas de subtarefas, doze horas, sem desvio do objetivo.
Meio milhão de fórmulas de planilhas. Neon espalhou 100.000 células em subplanilhas e escreveu mais de 500.000 fórmulas ativas para fazer detecção de bordas Sobel e mapeamento de profundidade 3D sem biblioteca de imagens. Seis modos de interação alternam a visualização e a alteração do ângulo de luz reacende a imagem em tempo real. Este testa se o raciocínio sobrevive sendo escrito como código que deve permanecer correto em escala.
Um simulador de esqui escrito do zero. 10.200 linhas de shaders WebGL2 personalizados, um mecanismo de física de 120 Hz, seis pistas de montanha, trilhas dinâmicas de neve, avalanches de lajes, áudio espacial e dados reais de elevação do Mont Blanc e Chamonix. Nenhum ativo 3D pré-fabricado. Aqui o teste é a engenharia de código longo: shaders, física, terreno e áudio precisam ser mantidos juntos em um único projeto.
Como Neon e Hydrogen dividem o trabalho
No Antigravity, o Neon pode trabalhar sozinho ou atuar como orquestrador. Ao receber uma tarefa grande, ele a divide e distribui as partes para subagentes Hydrogen que trabalham em paralelo. O Hydrogen é o modelo leve e mais rápido da família, pela metade do preço do Neon.
A divisão é clara: o Neon planeja, avalia e aprova. O Hydrogen escreve código, edita arquivos e executa testes. Se o trabalho de um subagente não passar pela revisão, ele volta com instruções em vez de ser aceito.
A recente proposta de superagente da DeepSeek parece semelhante à distância, mas resolve um problema diferente. Swarm consiste em dividir uma tarefa entre vários agentes. Superagente é um sistema de longa execução que rastreia muitas tarefas ao mesmo tempo, com um roteador combinando mensagens com os trabalhadores. Ambos separam a coordenação da execução e ambos mantêm um ciclo de feedback. Eles diferem em escopo, em quem faz o raciocínio e em onde se situa o modelo forte. O Google coloca seu modelo mais forte no topo. O design do DeepSeek baseia-se em um roteador mais leve com trabalhadores mais fortes.
Onde o Neon ainda fica atrás
Dois benchmarks mantêm o Opus 5.5 na frente: Terminal-bench 4.1 e FrontierCode 2.0. Ambos se baseiam no trabalho do terminal e no reparo do código, e a vantagem é descrita como leve, em vez de decisiva. A margem do agente de codificação também é pequena, 58,6 contra aproximadamente 58, o que significa que um novo equipamento ou um novo benchmark pode inverter a ordem.
O que se mantém melhor é o rendimento e o preço. Concluir uma tarefa em 21 minutos por US$ 6,86 altera quantas vezes você pode executar um agente antes que o custo se torne o limite.
Planos de codificação
Se você estiver comparando o acesso ao modelo para o trabalho do agente, nossa página plano de codificação lista os planos que temos atualmente em estoque e o que cada um inclui.
Veja os planos de codificação atuais
Verifique os detalhes do plano em relação à sua própria carga de trabalho antes de comprar.
O que isso significa para desenvolvedores
- O custo por tarefa merece a mesma atenção que a pontuação. Quando um agente trabalha algumas centenas de vezes por dia, 45% de desconto na conta importa mais do que um ou dois pontos.
- A orquestração muda o orçamento. Um planejador forte e trabalhadores paralelos baratos podem minar um modelo forte que faz tudo, desde que a etapa de revisão realmente rejeite o trabalho ruim.
- Verifique o chicote antes de comparar números. As pontuações do agente são anexadas à CLI e ao andaime que as produziu.
- Mantenha um segundo modelo por perto. Neon não é o primeiro em todos os testes e sua liderança de codificação é pequena o suficiente para desaparecer no próximo lançamento.